Сегодня генеративный ИИ является привычным инструментом, который помогает в работе и быту, хотя ещё пять лет назад мы не представляли, что мир изменится настолько сильно.
На самом деле нейросети существуют более 70 лет, просто долгое время они представляли собой скорее научный эксперимент, а теперь доступны всем желающим.
КРАТКО ▾
1950-е. Первые шаги на огромных компьютерах
В середине прошлого века учёные пытались описать работу мозга при помощи математики.
Значимый прорыв совершил британский математик Алан Тьюринг. Он предложил практический эксперимент, позднее получивший название тест Тьюринга, который определяет способность машины к мышлению (современные ИИ его легко проходят).
До современных чат-ботов тогда оставались десятилетия. Но сама идея компьютера, с которым можно общаться обычным языком, уже была сформулирована.
1958 год. Появился перцептрон — предок современных нейросетей
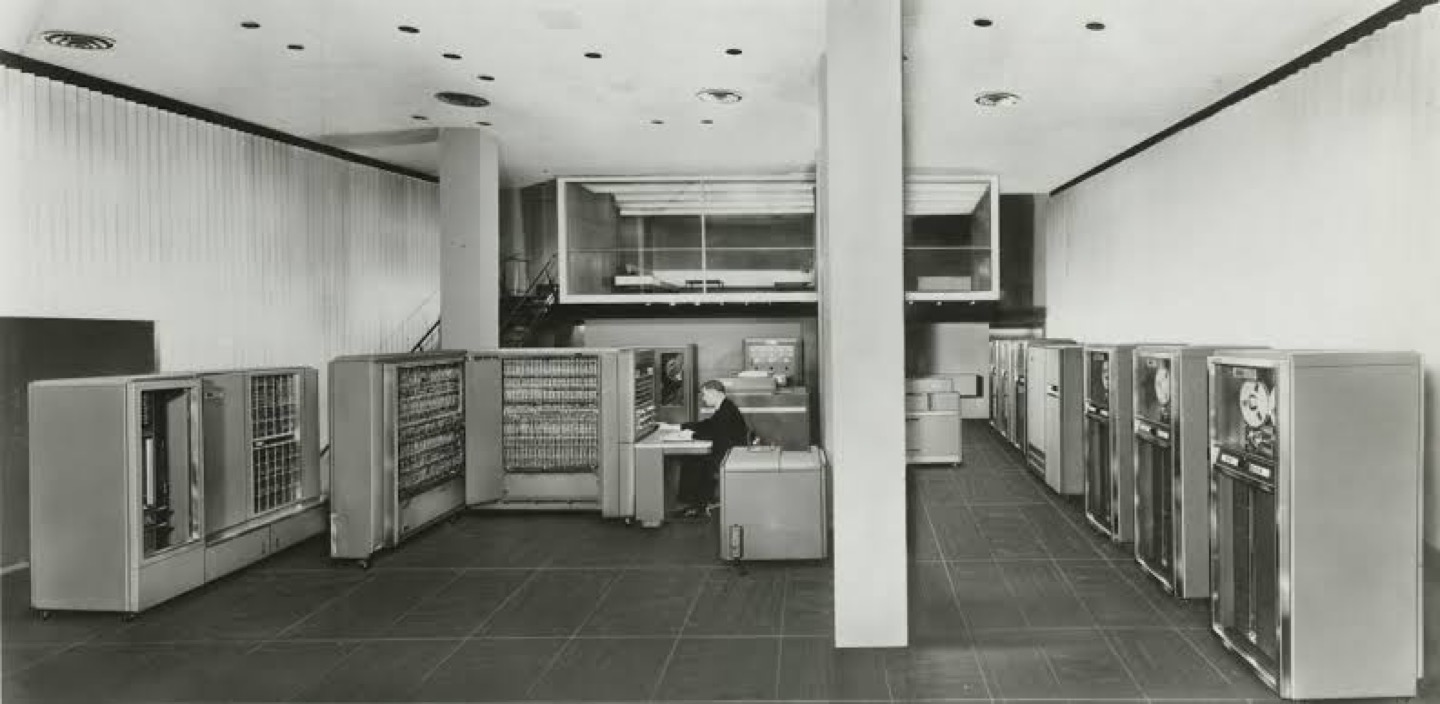
IBM 704, который использовал Розенблатт.
В 1958 году произошло ещё одно важное событие: Фрэнк Розенблатт представил перцептрон — математическую модель восприятия информации мозгом человека. Демонстрация прошла на компьютере IBM 704, который работал на электронных лампах и весил несколько тонн. Модель Розенблатта научилась отличать карточки с отметками слева от карточек с отметками справа.
Уникальность заключалась в том, что у компьютера не было заранее подготовленных инструкций. Он самостоятельно корректировал алгоритм на основе предыдущих ошибок.
Перцептрон наглядно продемонстрировал один из важнейших принципов машинного обучения: вместо жёстко заданных правил система может корректировать свои параметры на основе примеров и ошибок.
Но, несмотря на эти прорывы, мощность компьютеров была слишком низкой. Розенблатт использовал один из самых мощных в мире компьютеров для демонстрации простой по нынешним меркам задачи. Для более сложных вещей мощностей не хватало очень долго.
1969 год. Выяснилось, что у первых нейросетей слишком много ограничений
После появления перцептрона казалось, что возможности таких систем можно значительно расширить, увеличивая их размер. Это заблуждение развеяли математики Марвин Минский и Сеймур Пейперт в своей книге Перцептроны, которая вышла в 1969 году.
Главная проблема заключалась в устройстве перцептрона. Он получал входные данные, присваивал им определённый вес и сразу выдавал результат. Между входом и выходом не было дополнительных слоев, которые могли бы обрабатывать информацию.
Из-за этого один перцептрон мог решать только задачи, в которых данные можно разделить простой линейной границей. Существовали задачи, с которыми он не справился бы независимо от количества примеров для обучения.
Для решения более сложных задач требовались многослойные нейросети со скрытыми слоями. Они позволяют последовательно преобразовывать данные и находить более сложные закономерности.
Это для нас сейчас звучит понятно и привычно, но для 1969 года это была сложная теория, которая упиралась в неприятное ограничение: эффективного способа обучения многослойных моделей не существовало.
1980-е. Учёные научили нейросети исправлять свои ошибки
В 1974 году советский учёный Александр Галушкин разработал метод обратного распространения ошибки, а в 1986 году его доработали Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс.
Если сильно упростить, сеть сначала пытается решить задачу, затем сравнивает ответ с правильным и выясняет, какие внутренние связи сильнее всего повлияли на ошибку. После этого их параметры немного корректируются. Процесс повторяется снова и снова, иногда миллионы или миллиарды раз.
Таким образом, учёные нашли способ, как быстро обучать многослойные нейросети. Этот процесс лежит в основе обучения современных нейросетей, где информация проходит не через один простой алгоритм, а через множество связанных уровней.
Но в 80-х это были очень ограниченные нейросети, потому что индустрия упиралась в две проблемы: нехватку мощности и данных.
1990-е годы. Интернет решил главную проблему с обучением нейросетей
В 90-х началось массовое распространение компьютеров и интернета, что привело к резкому увеличению доступной информации, которая необходима для обучения ИИ.
Раньше ученые самостоятельно собирали небольшие объемы данных для демонстрации своих нейронок. Интернет стал для всего мира гигантским источником текстов, изображений, документов, музыки и других данных.
В нулевых развитие интернета ускорится ещё сильнее. Появятся многие привычные сервисы, а информации станет так много, что один человек никогда в жизни не сможет её прочитать.
2000-е годы. Для нейросетей неожиданно пригодились видеокарты
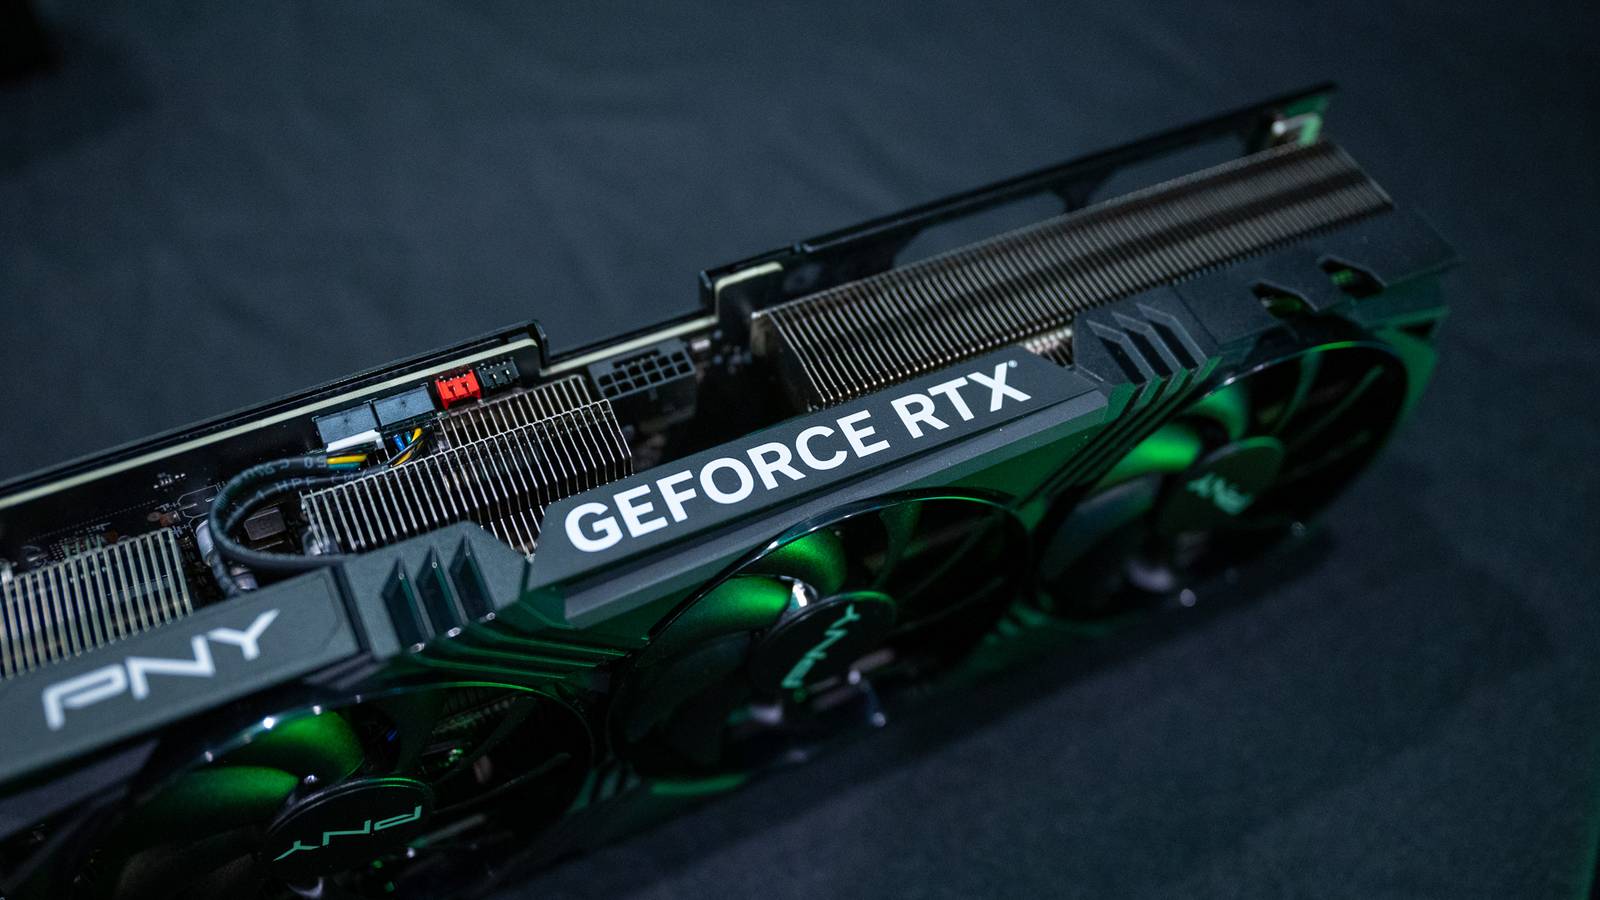
В нулевых начали активно развиваться видеокарты. Изначально они создавались для обработки компьютерной графики. Их главное преимущество заключается в умении одновременно выполнять огромное количество похожих математических операций.
В это же время выяснилось, что подбная архитектура идеально подходит для обучения нейросетей. Исследователи наконец-то научились быстро проводить параллельно огромное количество вычислений.
2010-е. Нейросети научили распознавать изображения
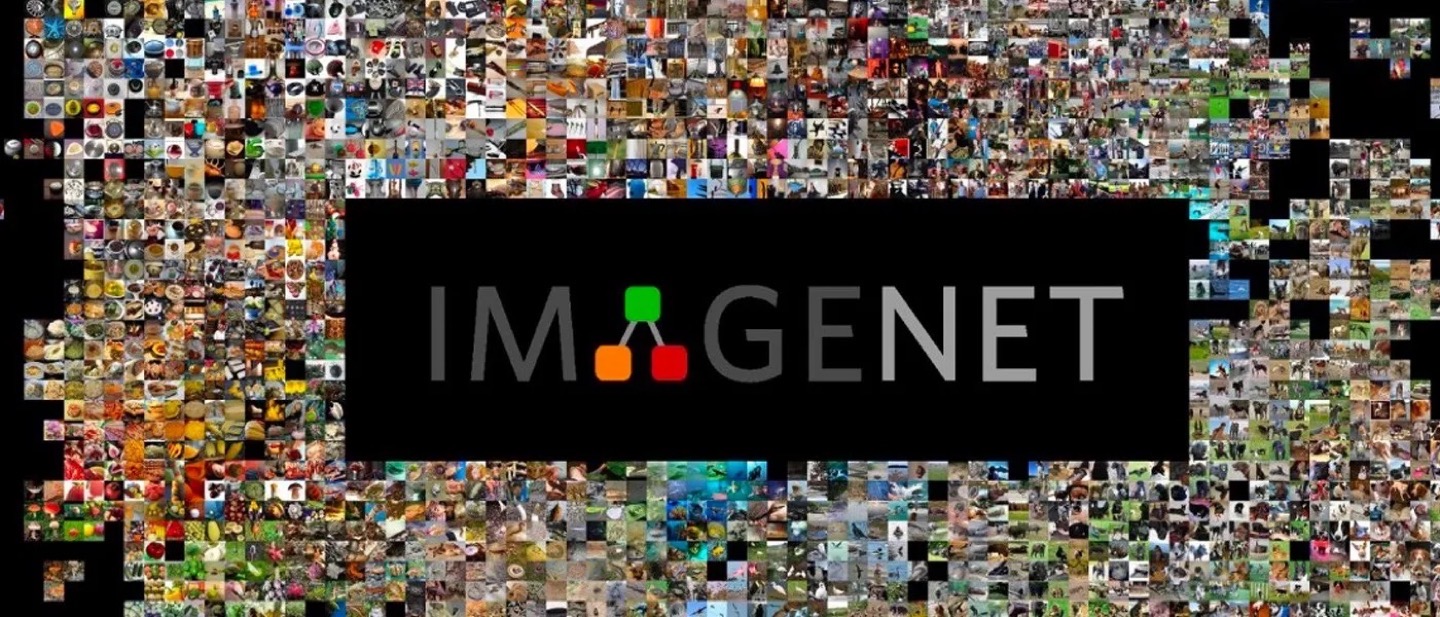
В 2009 году появилась гигантская база данных ImageNet, которая насчитывает более 14 млн изображений. Она была создана специально для обучения нейросетей и машинного зрения.
В 2012 году исследователи Алекс Крижевский, Илья Суцкевер и Джеффри Хинтон представили нейросеть AlexNet с 60 млн параметров, которая распознавала изображения ImageNet намного лучше конкурентов.
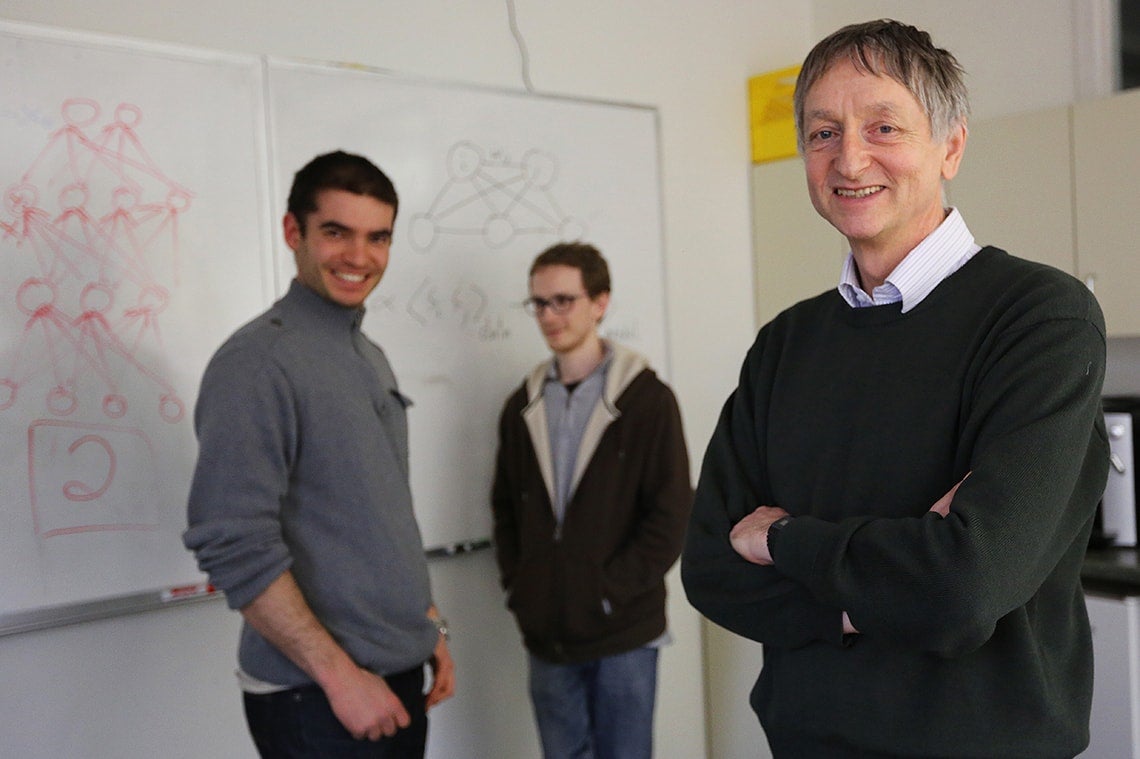
Алекс Крижевский, Илья Суцкевер и Джеффри Хинтон.
До 2012 года компьютерное зрение строилось на сложных математических формулах, которые люди придумывали вручную, чтобы научить компьютер «видеть» края или углы объектов. Разработчики AlexNet обучили нейросеть самостоятельно находить отличительные признаки.
AlexNet победила с показателем ошибок 15,3% (отрыв от второго места — 10%). После этого началась гонка нейросетей.
Но эта гонка упиралась в две проблемы: нехватку мощности и проблемы с обработкой текста.
Разработчики AlexNet придерживались подхода, согласно которому глубина модели имеет решающее значение для её высокой производительности. Но для этого требуется много ресурсов, которые было предложено компенсировать с помощью видеокарт.
2017 год. Появление технологии, которая научила нейросети быстро работать с текстом
В 2017 году группа учёных из Google представила статью под названием Attention Is All You Need («Внимание — это всё, что вам нужно»), в которой впервые были представлены трансформеры.
До этого различные ИИ-модели обрабатывали текст слово за словом. Из-за этого им было сложнее работать с длинными предложениями и учитывать связи между словами, которые находятся далеко друг от друга. Также эти ограничения фактически делали ИИ бесполезным для больших текстов.
Трансформер работает иначе. Он рассматривает слова в контексте друг друга и определяет, какие части текста наиболее важны для понимания каждой конкретной части.
Например, в предложении «Маша положила мороженое в холодильник, потому что на улице было жарко» модели важно связать «мороженое» с «холодильником» и «жарко». Трансформер позволяет учитывать эти связи, не передавая информацию последовательно от одного слова к следующему.
Также трансформеры могут выполнять много вычислений параллельно, ускоряя обработку текста за счёт ресурсов видеокарт.
2018–2020 годы. Началась эпоха больших языковых моделей
После появления трансформеров исследователи начали увеличивать размеры языковых моделей и объёмы данных для их обучения.
Выяснилась важная закономерность: большое количество данных для обучения позволяет модели справляться с множеством различных задач. Модель может писать текст, отвечать на вопросы, переводить текст, создавать код и выполнять другие инструкции.
Вместо того, чтобы создавать отдельную нейросеть для каждой задачи, разработчики наоборот начали расширять возможности одной модели. Так начала формироваться идея универсальной большой языковой модели — LLM, которая сейчас лежит в основе всех чат-ботов и ИИ-агентах.
Именно благодаря LLM чат-боты обладают настолько широкими возможностями.
2022 год. Нейросеть превратилась из технологии для специалистов в обычный чат
В начале 20-х уже существовали большие языковые модели, но они все равно оставались нишевым инструментом, недоступным для большинства людей.
Отчасти это было связано с тем, что для работы с LLM требовались определенные навыки и понимание того, как работают нейросети и машинное обучение.
Все изменилось в конце 2022 года после ChatGPT на базе GPT-3.5. OpenAI первой сделала простой интерфейс для взаимодейтсвия с LLM. Пользователь мог написать в чате любой вопрос и тут же получить на него ответ. Можно было уточнить вопрос, попросить переписать ответ, объяснить его понятнее. Это казалось чем-то невероятным, потому что ничего подобного раньше не было.
2023 год. В России появился ГигаЧат
В апреле 2023 года Сбер представил ГигаЧат, который на тот момент объединял в себе несколько нейросетей компании: ruGPT, FRED-T5, модель для работы с изображениями ruCLIP и генеративную модель Kandinsky.
В 2024 году ГигаЧат получил многие привычные функции, в том числе научился работать с документами и изображениями. Кроме того, сервис уже работал на основе одноименной модели GigaChat.
2025 год запомнился переходом на GigaChat 2. Сбер представил сразу несколько версий модели: Lite, Pro и Max.
Все они создавались под разные задачи. Например, Lite — это базовая модель, которая ориентирована на быстрые и простые запросы, а Max создавалась специально для выполнения сложных задач с множеством условий.
В 2026 году вышли GigaChat 3 Ultra и GigaChat 3.5 Reasoning. Последняя стала первой моделью Сбера, которая специально создавалась для сложных рассуждений, когда от модели требуется не просто дать ответ, а самой проанализировать его и решить насколько он будет правильным и качественным для пользователя.
Как обучаются современные модели

В 2020-х появилось всё, что нужно для обучения больших нейросетей: огромные массивы данных, большая вычислительная мощность и современные методы обучения и обработки информации.
Обучение языковых моделей, которые лежат в основе всех современных чат-ботов, происходит примерно по одному и тому же принципу. Сначала моделям показывают огромное количество текста и заставляют предсказывать продолжение. Затем модели дополнительно учат выполнять инструкции и корректируют их ответы с использованием человеческой обратной связи.
Качество готовых моделей сильно зависит от того, на каких данных обучали модель, сколько у неё параметров, как устроена сама архитектура и что происходило после основного обучения. Например, одну модель можно обучить на большем количестве русскоязычных текстов, а другую — на программном коде. На выходе мы получим абсолютно разные модели.
По этой же причине компании постоянно выпускают новые поколения моделей. Разработчики увеличивают объём и улучшают качество обучающих данных, меняют архитектуру, совершенствуют методы обучения и дополнительной настройки.
GigaChat как раз обучают преимущественно на российских данных, поэтому модели этой линейки лучше понимают российский контекст, законы и различные нормы.
Что будет дальше
Нейросети прошли долгий путь от научных работ до привычного инструмента.
Современные ИИ-помощники уже не требуют от пользователя знания команд или языков программирования. Задачу можно сформулировать простым языком.
Но и это уже не является главной фишкой нейросетей. Сейчас разработчики больше сосредоточены на ИИ-агентах, которые не только понимают запросы пользователя, но и могут самостоятельно выполнять за него задачи. В ближайшем будущем ИИ-агентов будет становиться больше, и они смогут решать различные повседневные задачи, экономя наше время.

Сюда так и просится мощный комментарий