На первый взгляд сравнивать российские и зарубежные нейросети довольно просто. Можно открыть несколько рейтингов, посмотреть результаты тестов на математику, программирование и логику и объявить победителя.
Но обычные пользователи редко просят нейросеть решить олимпиадную задачу по математике. Гораздо чаще их волнуют повседневные вопросы: как получить налоговый вычет, как пожаловаться на управляющую компанию или как называется актуальный ГОСТ.
И здесь внезапно оказывается, что самая мощная нейросеть — не всегда самая полезная. Разбираемся, почему российские модели иногда знают нашу реальность лучше зарубежных.
КРАТКО ▾
Не все российские нейросети создаются одинаково
Прежде чем сравнивать российские и зарубежные нейросети, важно разобраться в том, как они создаются.
Существует два основных подхода: взять за основу уже существующую модель или обучить собственную с нуля.
Первый способ проще и быстрее. Обычно разработчики используют открытые LLM, например Qwen. Они получают готовые веса модели, которая уже обладает знаниями о языке, фактах и базовых закономерностях, а затем адаптируют её под русский язык и конкретные задачи.
Во время дополнительного обучения модель получает новые данные, а её веса изменяются. В результате её поведение может заметно отличаться от исходной зарубежной версии.
Обучить модель с нуля значительно сложнее, зато разработчики получают полный контроль над её архитектурой и процессом обучения. Это позволяет максимально адаптировать модель под собственные требования. Именно такой подход Сбер использует при разработке GigaChat.
Почему под капотом все похоже, но результат разный
Несмотря на разные способы создания, большинство современных больших языковых моделей устроены примерно одинаково: все используют трансформеры, токенизацию текста, обучаются на больших данных, а поведение настраивается вручную.
Поэтому все нейросети, по факту, одинаково понимают текст и отвечают на вопросы по одному и тому же алгоритму.
Разработчики решают, какой язык будет приоритетным, какие источники использовать для обучения и как нейросеть сможет с ними взаимодействовать.
В результате один ИИ может отлично понимать русский язык, сленг, знать законы РФ, а другой — ошибиться в незначительной на первый взгляд детали, но тем самым испортить весь ответ.
При создании моделей разработчики обучают модели различному сленгу и российским особенностям, которые понятны только людям, которые живут в России.
Поэтому российскому ИИ не надо объяснять, что при оформлении документов людей интересует не только алгоритм, а также различные детали, которые зарубежная модель может посчитать незначительными.
Почему зарубежные нейросети чаще ориентированы на английский, а ГигаЧат на русский
Помимо обучающих данных, российские и зарубежные нейросети имеют разные токенизаторы — технологии, которые обрабатывают текст.
Все нейросети разбивают текст на токены, которые могут представлять целые слова, части слов, знаки препинания или символы. Например, слово computer один токенизатор может распознать как единый элемент, а другой — разбить на несколько частей.
С русским языком токенизаторам работать сложнее из-за его сложной структуры. Поэтому зарубежные ИИ обычно разбивают русские слова на большее количество элементов.
Это приводит к тому, что в Claude, Gemini и ChatGPT диалоги на русском занимают больше контекста и токенов, в то время как российские модели экономичнее обрабатывают кириллицу. При интеграции ИИ в свои продукты этот показатель может стать решающим в выборе моделей.
Разницу во владении языками признают и зарубежные разработчики. Например, Anthropic публикует результаты тестирования Claude на разных языках, принимая английский за базовый уровень. Русского языка в этом сравнении нет, однако все представленные языки показали результаты ниже английского.
Русский язык намного сложнее для модели, чем английский
Многие иностранцы отмечают, что русский язык сложен для обучения. В нем есть падежи, разные виды глаголов, огромное количество уменьшительных форм, свободный порядок слов, ирония и фразы, смысл которых плохо определяется буквальным переводом.
Нейросетям приходится всё это тоже учитывать. Но здесь у российских моделей есть важные преимущества — это и приоритетное обучение на русскоязычных текстах, и последующая настройка людьми, для которых русский язык является родным.
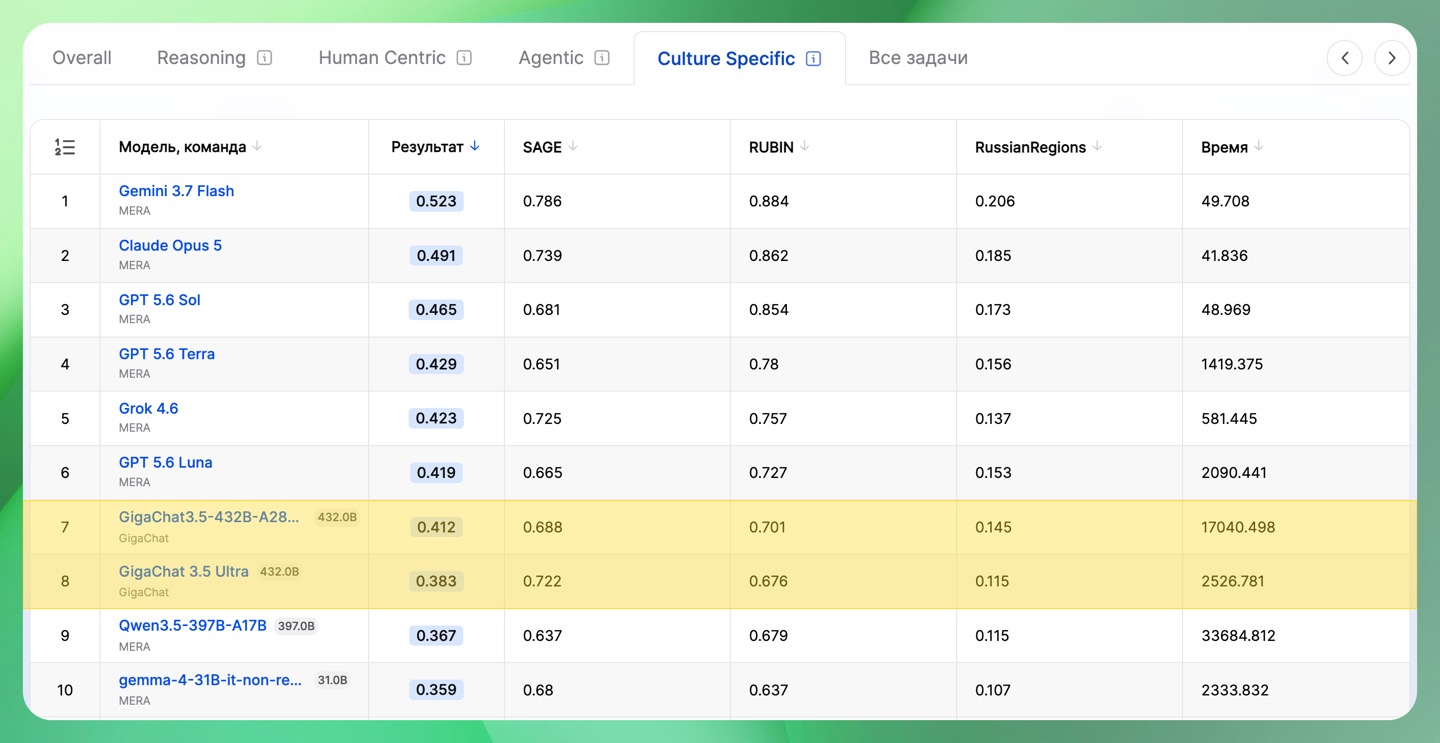
Например, в независимом бенчмарке MERA, который проверяет ИИ на знание русского языка и культурных особенностей, модели Сбера GigaChat 3.5 и GigaChat 3.5 Ultra входят в десятку лучших, обгоняя многие модели Qwen и Grok.
Зарубежные модели тоже знают русский язык, потому что их обучают на огромном массиве данных, в который в том числе входят тексты и научные статьи на русском языке.
Но российские нейросети целенаправленно оптимизируют под российские задачи и одновременно дают им доступ к российским источникам информации.
Тест 1. Законы и возврат товара: кто знает актуальный кодекс, а кто гадает
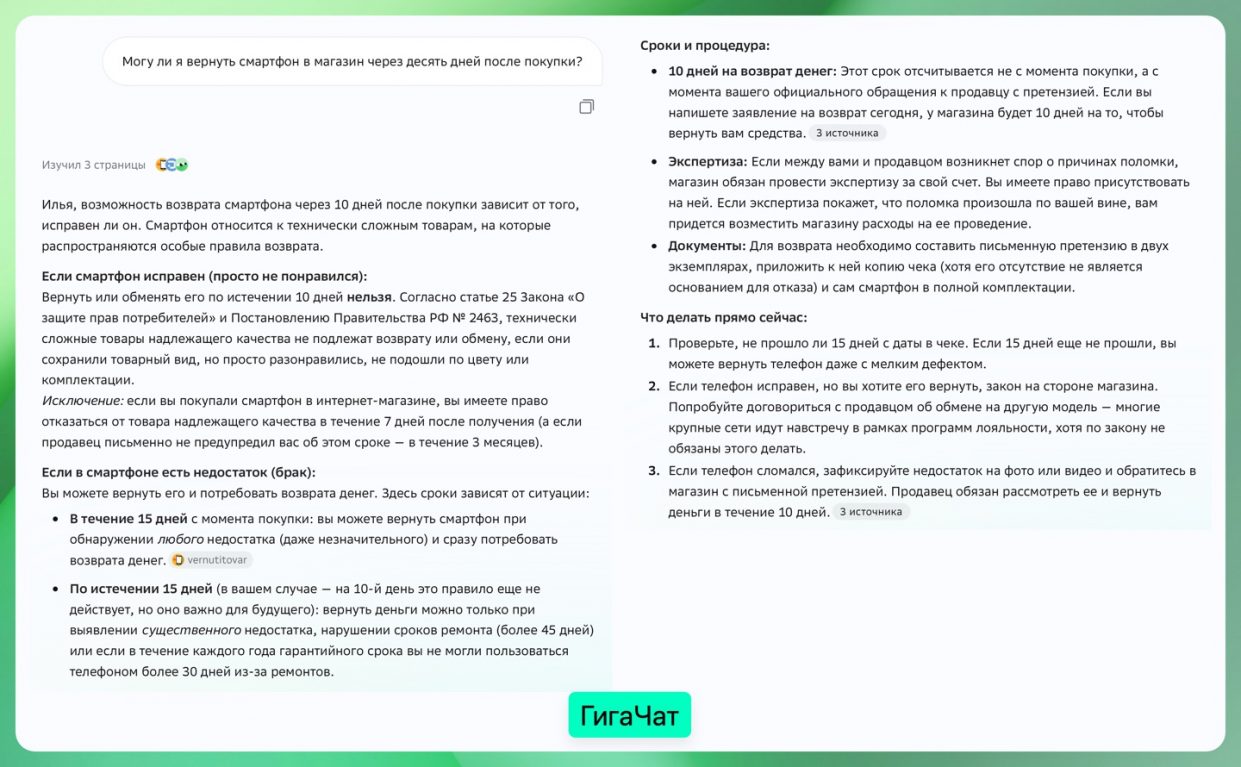
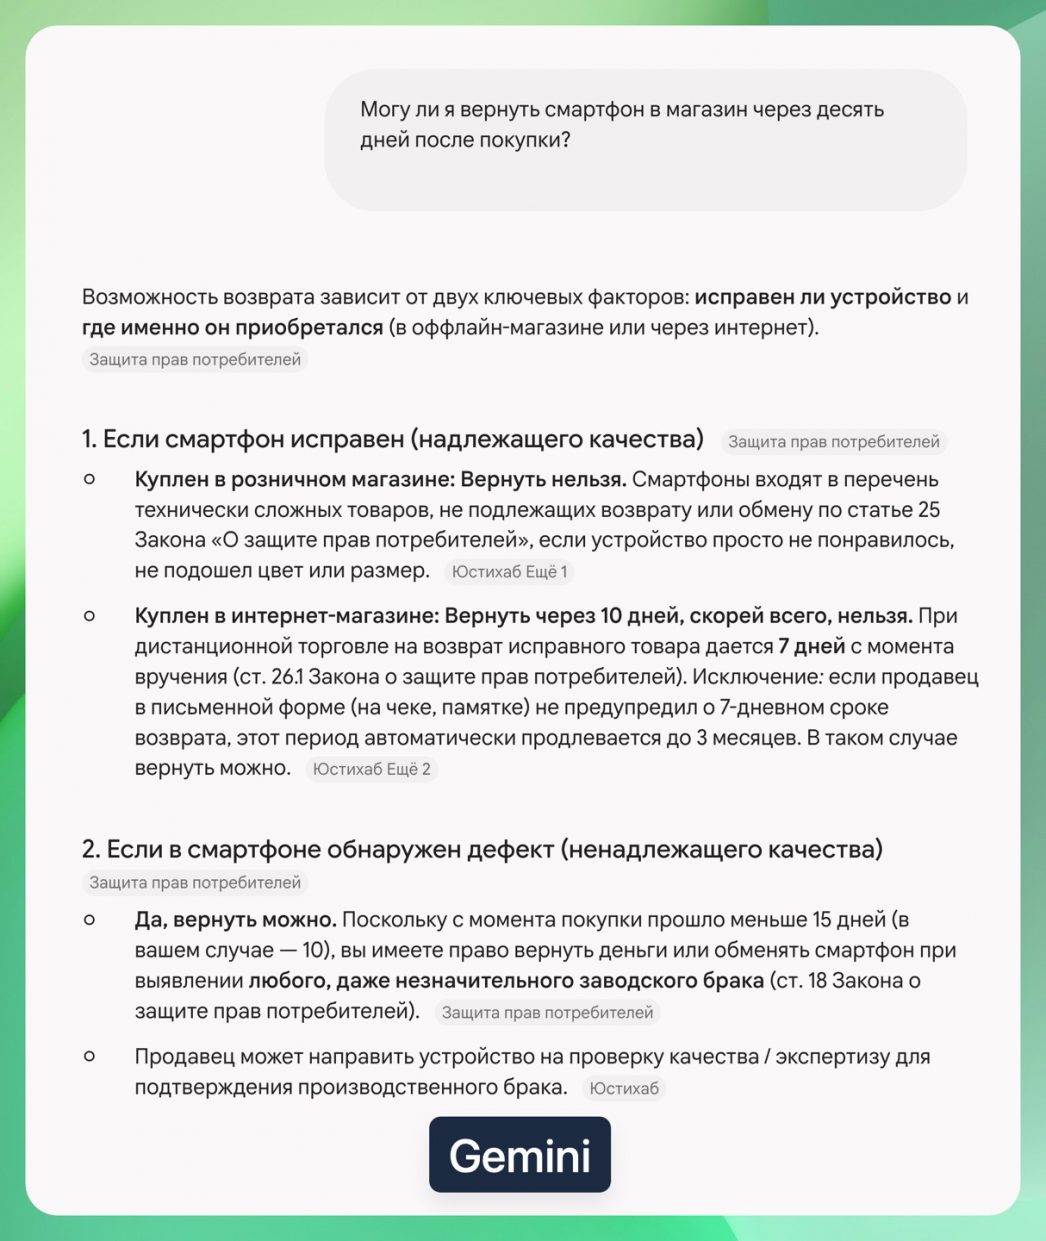
Сравнение ответов Gemini и ГигаЧата.
Российские ИИ отлично ориентируются в местных законах.
На вопрос «Могу ли я вернуть смартфон в магазин через десять дней после покупки?» мне примерно одинаково ответили ГигаЧат и Gemini, но модель Сбера намного понятнее расписала алгоритм действий, ссылаясь на российское законодательство.
Кроме того, законы в России постоянно меняются, поэтому важно, чтобы нейросеть ссылалась только на актуальные редакции.
Тест 2. 55 тысяч ГОСТов: почему зарубежный ИИ путает отмененные стандарты
С ГОСТами всё ещё сложнее. В официальной базе Росстандарта около 55 тысяч ГОСТов и национальных стандартов. Для каждого документа отдельно указывается его статус: действует, заменён, отменён, утратил силу или только принят.
Для зарубежных моделей это довольно узкая предметная область, а для российского бизнеса — обычные документы.
«Какой ГОСТ регулирует срок годности мороженого?» — этот вопрос я задал ГигаЧату и Claude.
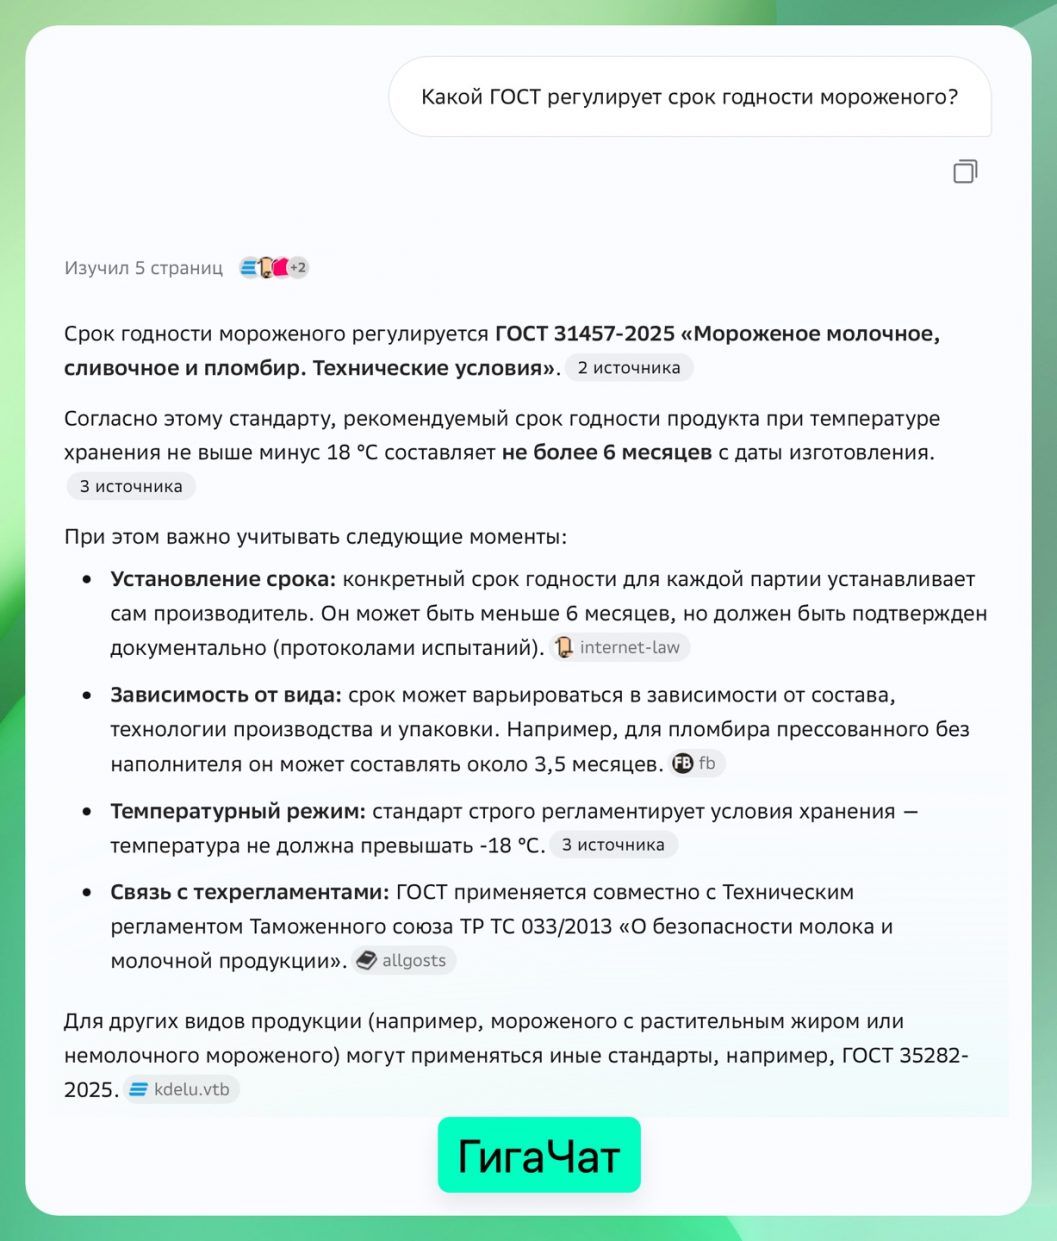
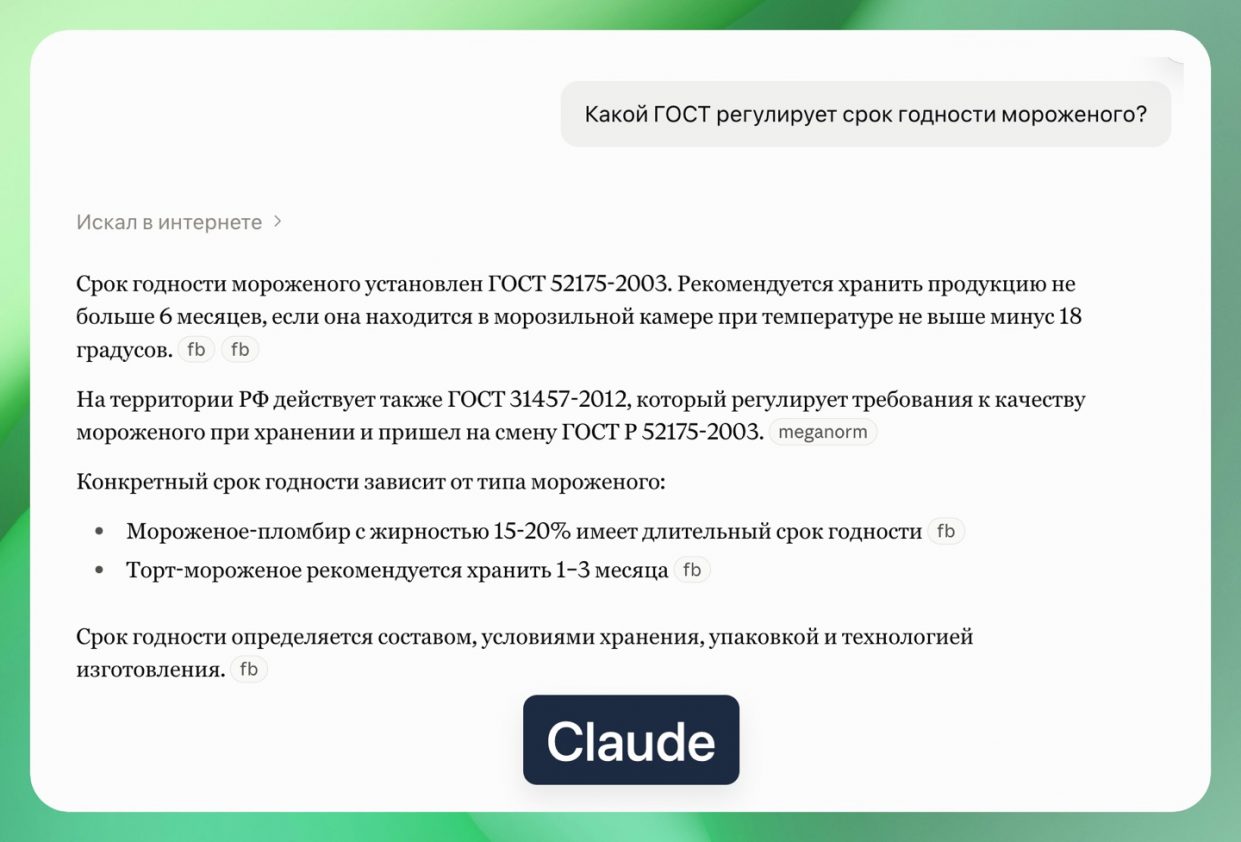
Сравнение ответов Claude и ГигаЧата.
Зарубежный ИИ дал правильный ответ, но сослался на неактуальный ГОСТ. ГигаЧат дал развернутый ответ согласно действующему ГОСТу.
Также модель Сбера упомянула актуальные технические регламенты, совместно с которыми применяется ГОСТ.
Тест 3. Квест на Госуслугах: от выписки из роддома до маткапитала
Госуслуги содержат огромное количество сервисов, в которых легко запутаться. Тут легко поможет ИИ, но ответ зарубежной нейросети и российской будет сильно отличаться.
🟢 Промпт
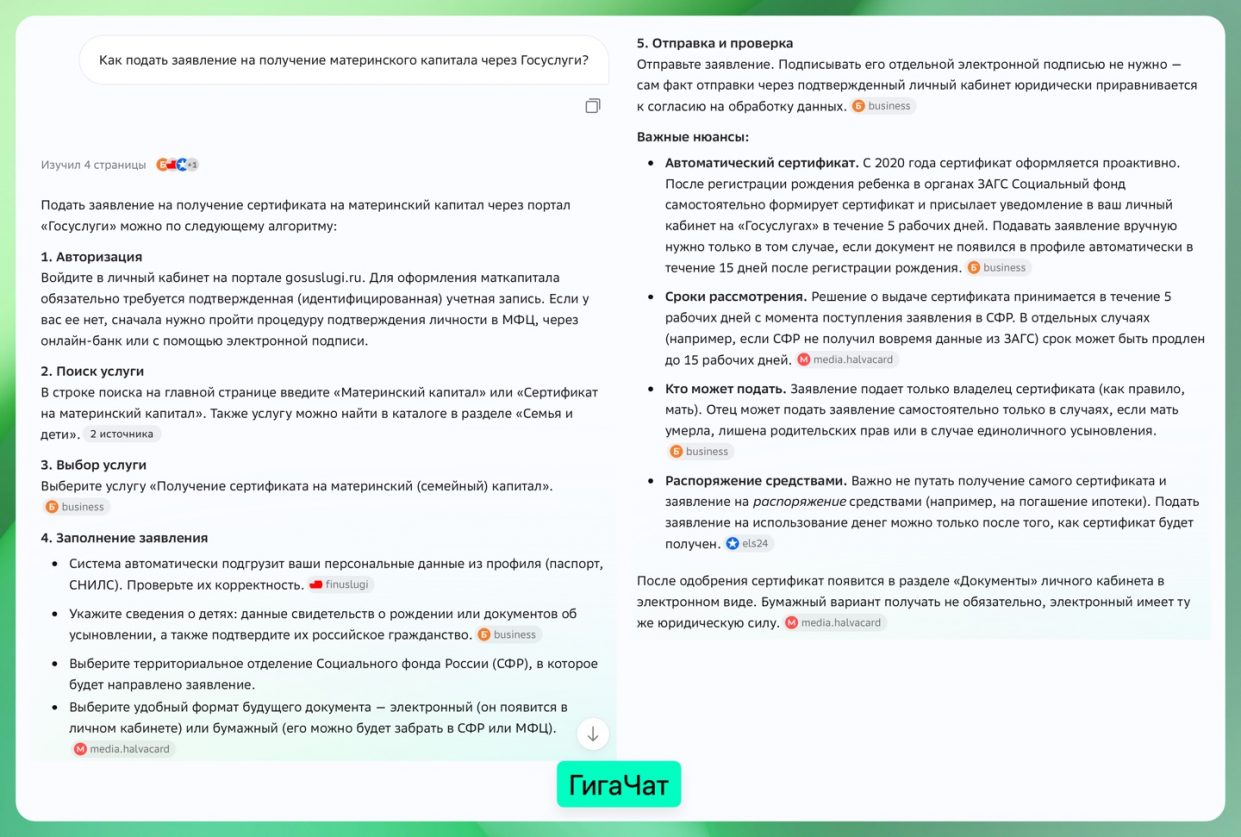
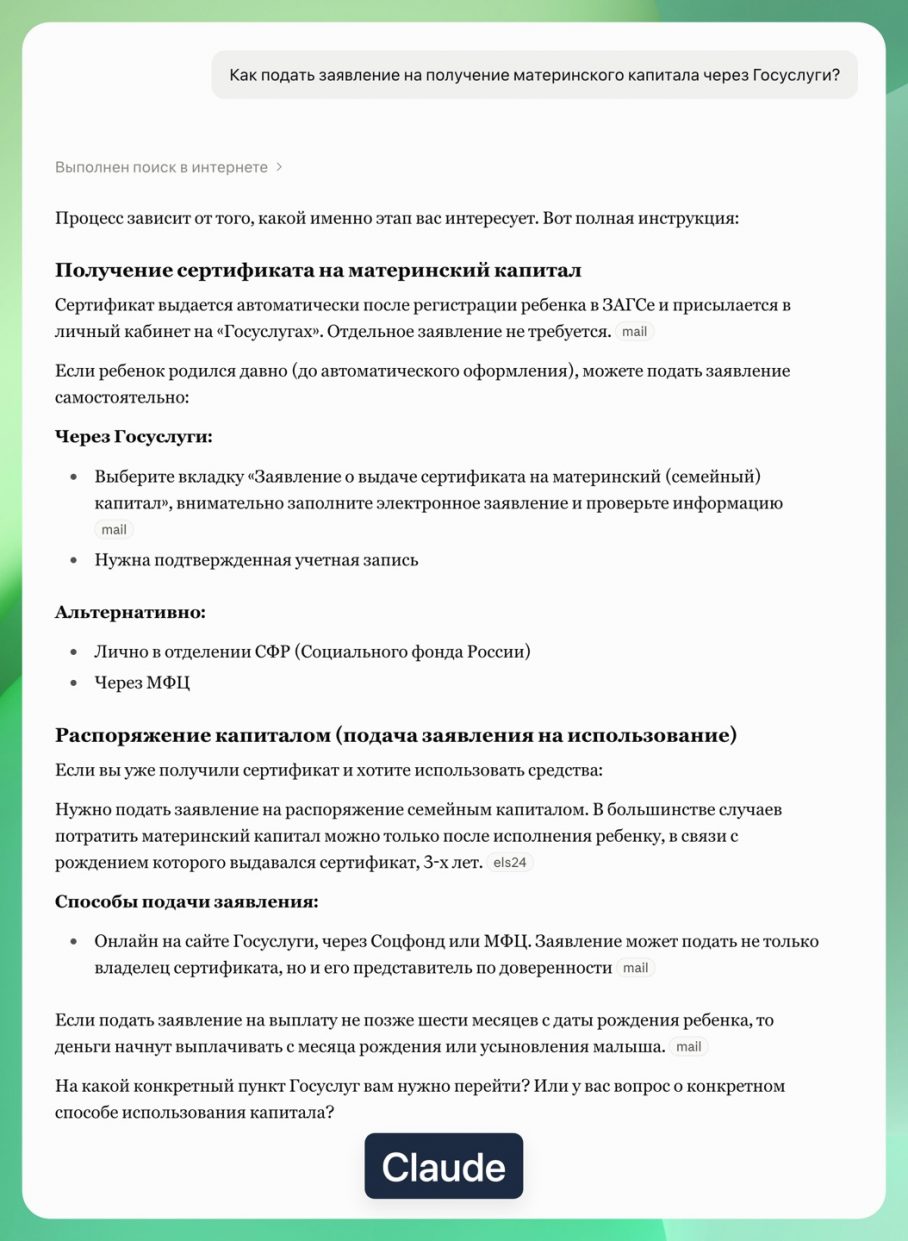
ГигаЧат выдал подробный гайд, объяснил, как найти услугу, какие сроки установлены и нюансы по выплатам. Claude сделал похожий гайд, но не вдавался в детали, которые могут быть очень важны при оформлении сертификата.
Немного усложнив запрос, ситуация кардинально меняется.
🟢 Промпт
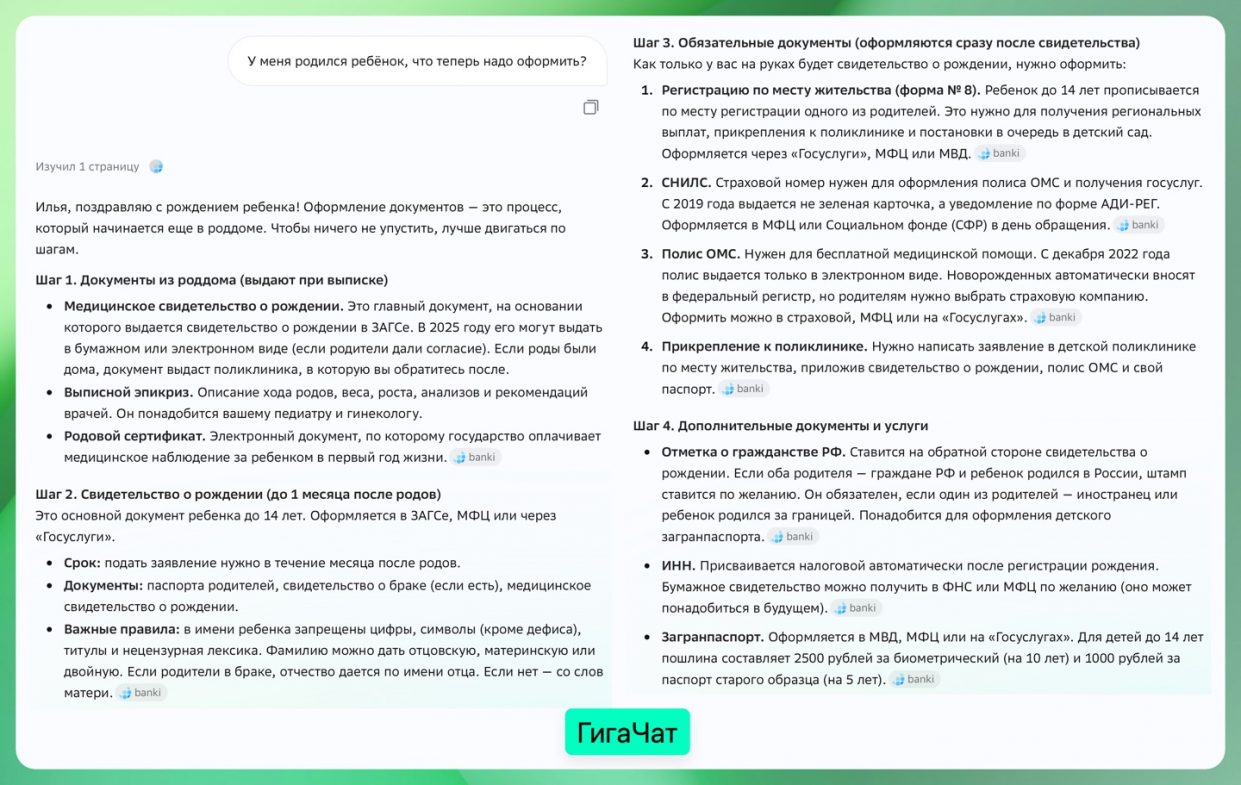
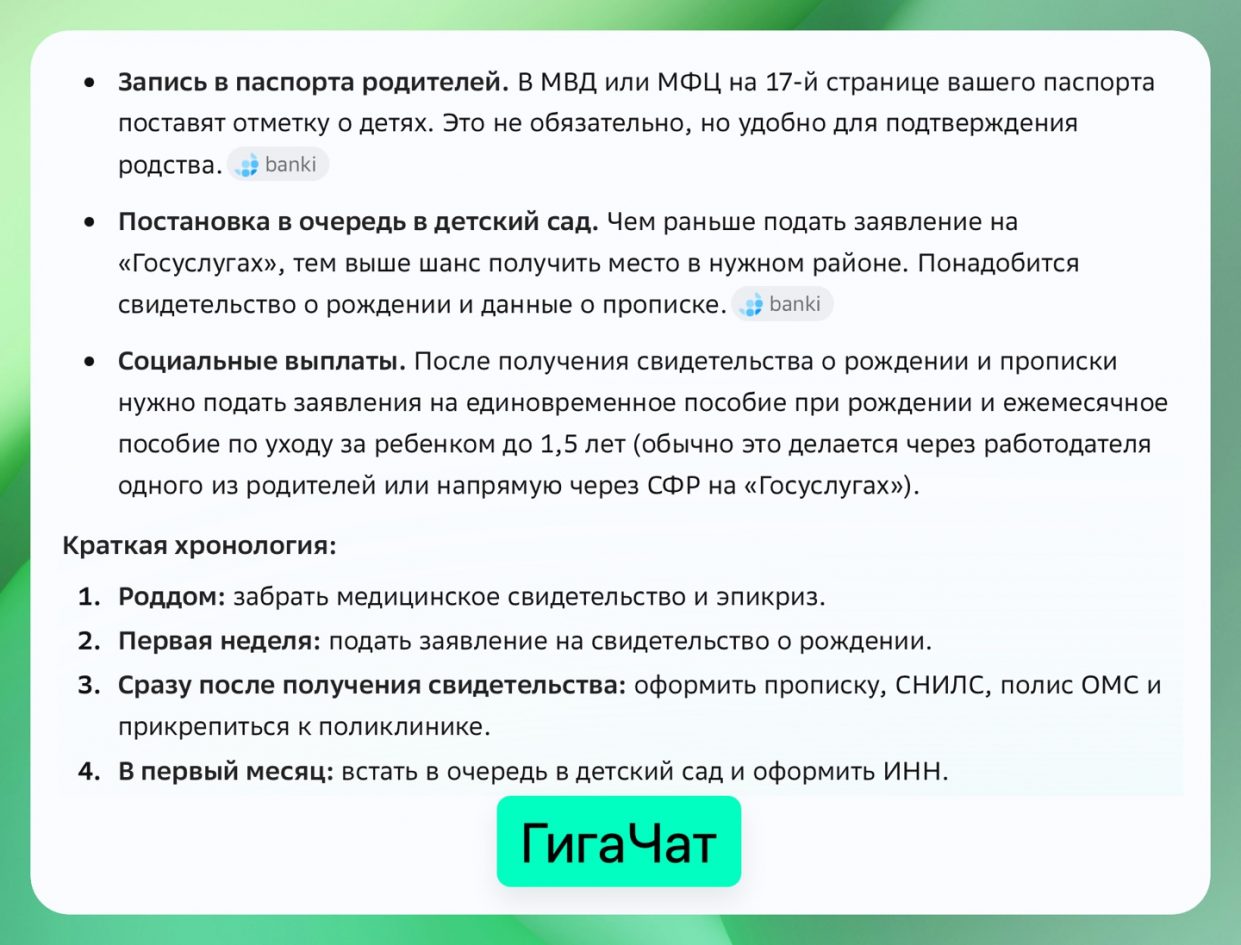
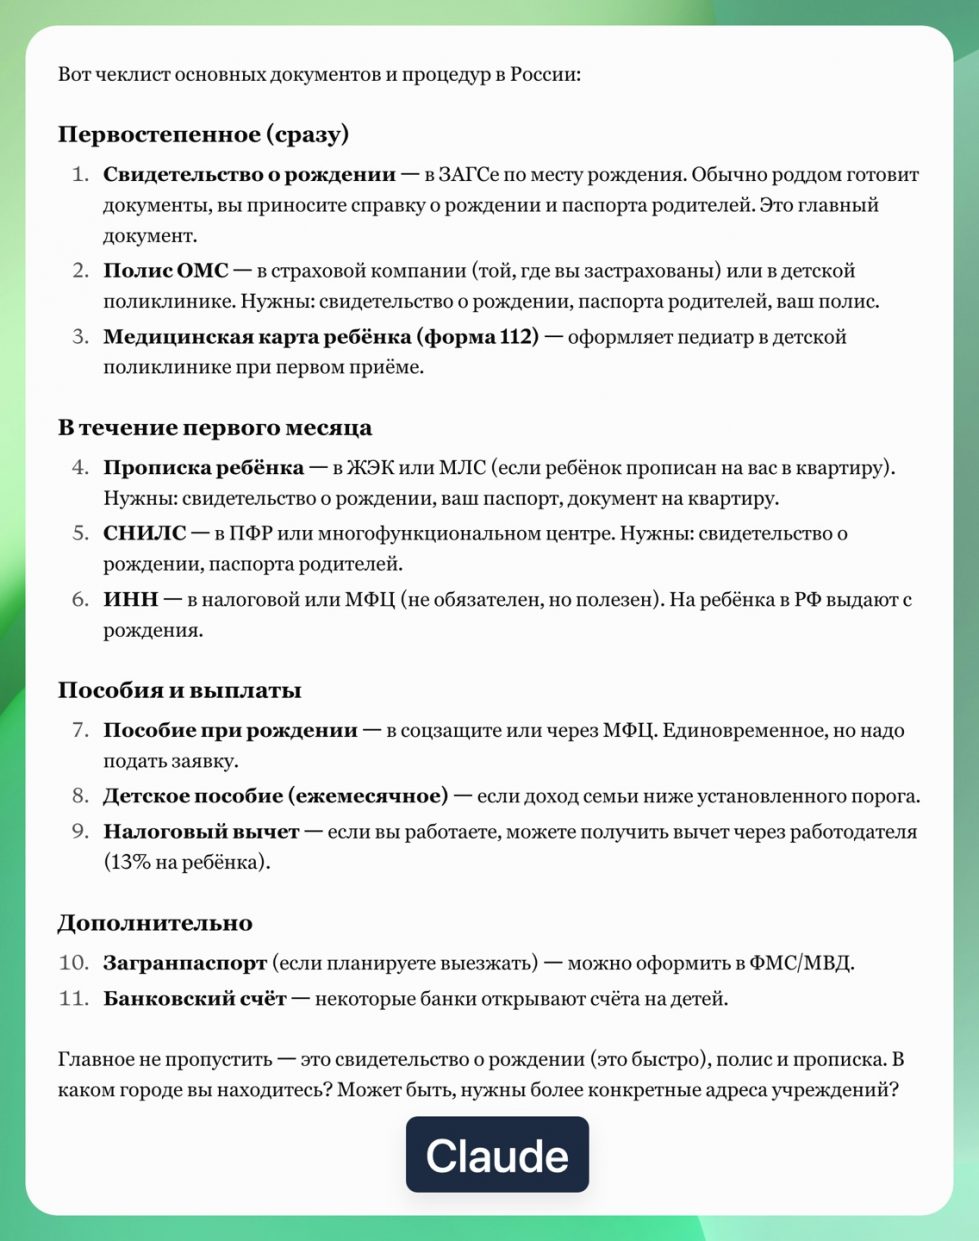
ГигаЧат сразу выдал развернутый ответ и начал с документов из роддома, которые дают при выписке. Claude сначала решил, что речь идет про Германию. Окей, спишем это на IP-адрес. Но после того, как я уточнил, что нахожусь в России, он выдал похожий список.
При этом Claude ничего не сказал про документы из роддома, а остальные документы были просто в виде списка, тогда как ГигаЧат сразу сообщил сроки и нюансы.
Итог: когда стоит запускать ГигаЧат
Хорошая локализация нейросети — это намного больше, чем способность правильно писать по-русски.
Модель должна понимать местные законы, сервисы, документы и десятки бытовых нюансов, о которых пользователь даже не задумывается, когда формулирует запрос.
Именно в таких задачах становится особенно заметно, зачем российским нейросетям собственные данные, отдельное обучение и настройка под пользователей из России.


5 комментариев