Вы задаёте нейросети сложный вопрос и через несколько секунд получаете уверенный и связный ответ. Кажется, будто она просто достаёт нужную информацию из огромной базы знаний.
Но разработчики не могли заранее подготовить миллионы вариантов на все случаи жизни. Тогда откуда нейросеть знает, что написать?
Разбираемся простыми словами, как на самом деле обучаются современные нейросети и что происходит внутри них, пока вы ждёте ответ.
КРАТКО ▾
1. Сначала для нейросети собирают огромный объём текстов
Чтобы нейросеть могла чему-то обучиться, сперва в неё требуется загрузить огромный объем текстов. Этот этап называется pre-training.
Качество текстов напрямую влияет на то, насколько умной будет нейросеть, поэтому важно загружать качественные тексты: научные статьи, тексты из интернета без рекламы, книги и код.
Одним языком ограничиваться нельзя. Кроме того, разработчики обязаны использовать либо открытые источники, либо заранее приобрести лицензию. То есть не каждый качественный текст можно использовать для обучения.
Например, при создании GigaChat 3.5 команда Сбера отобрала множество текстов на разных языках, включая научные статьи, код и математических данных. Все эти данные составили несколько триллионов токенов.
2. Весь текст превращается в токены
Языковые модели не видят слова так, как мы. Для них слово «часы» — это просто набор символов.
Просто загрузить весь текст в нейросеть нельзя, потому что, по сути, тогда никакой нейросети не будет, а вместо неё получится большая энциклопедия, которая просто будет показывать фрагменты текста.
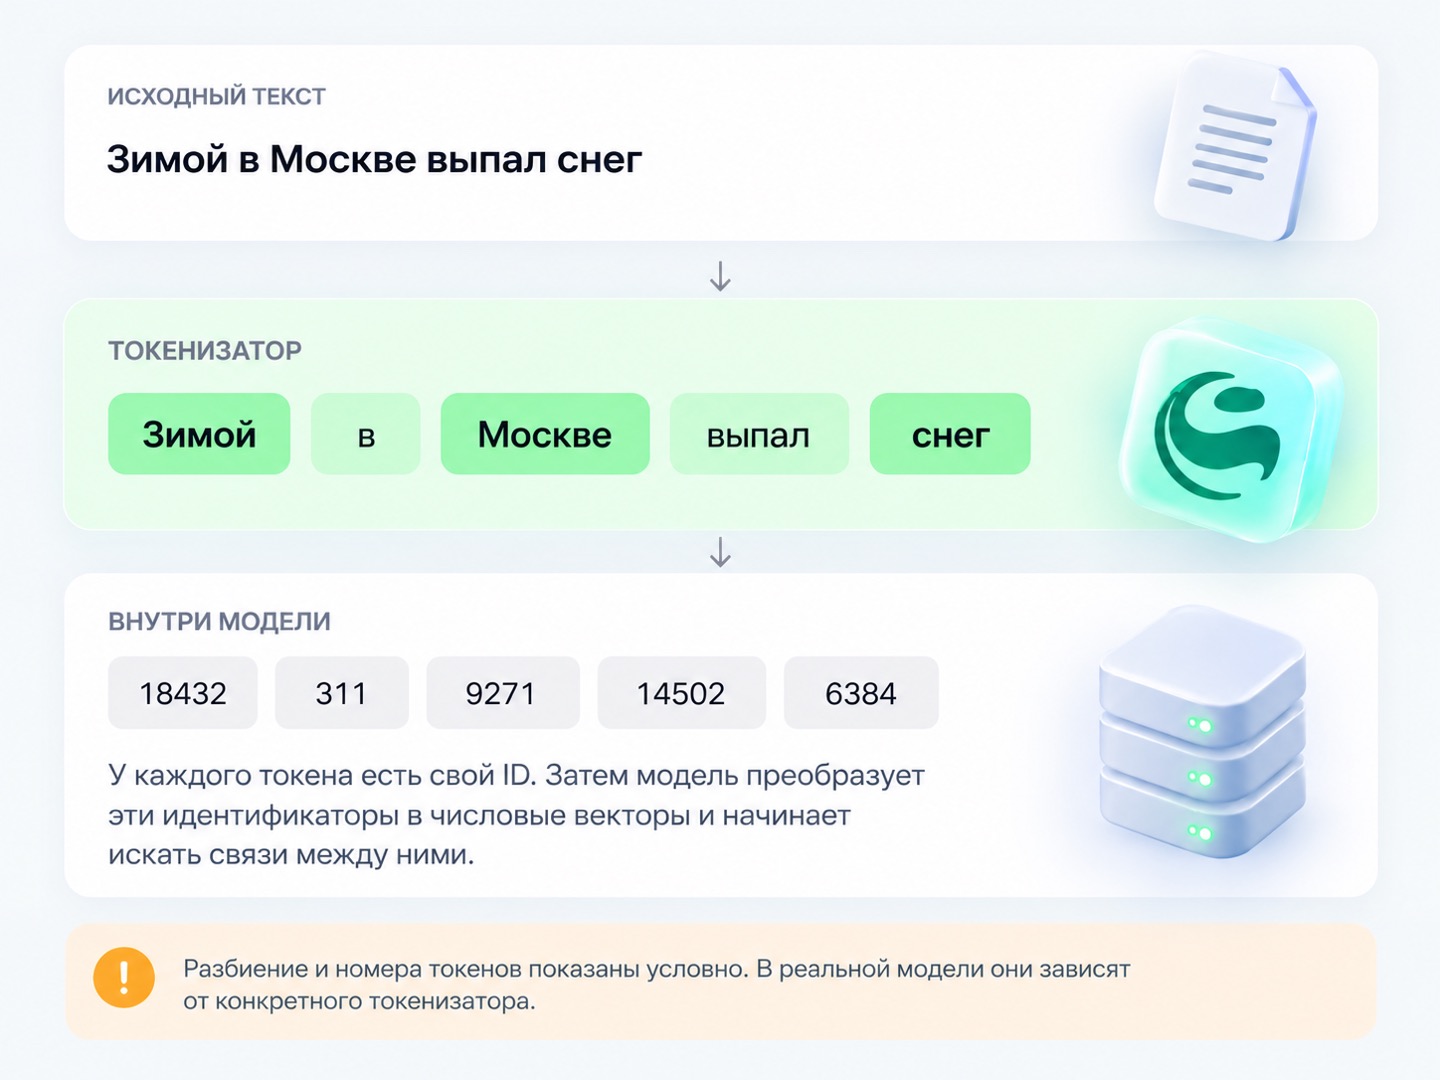
Поэтому перед обучением текст проходит через токенизатор. Он разбивает текст на небольшие элементы — токены. Один токен может содержать слово, часть слова, знак препинания или несколько символов. У разных моделей правила разбиения отличаются. Например, в GigaChat один токен содержит в среднем 3–4 символа.
Каждому токену присваивается числовое представление, с которым уже способна работать нейросеть. И здесь начинается само обучение.
3. Нейросеть учится предсказывать продолжение текста
После того как текст был разбит на токены, нейросеть учится правильно формировать предложения, постоянно сравнивая себя с оригиналом текста, который автоматически принимается за правильный ответ.
Система сравнивает своё предсказание с правильным продолжением и получает числовую оценку ошибки — loss. Чем меньше вероятность, которую модель присвоила правильному варианту, тем сильнее ошибка.
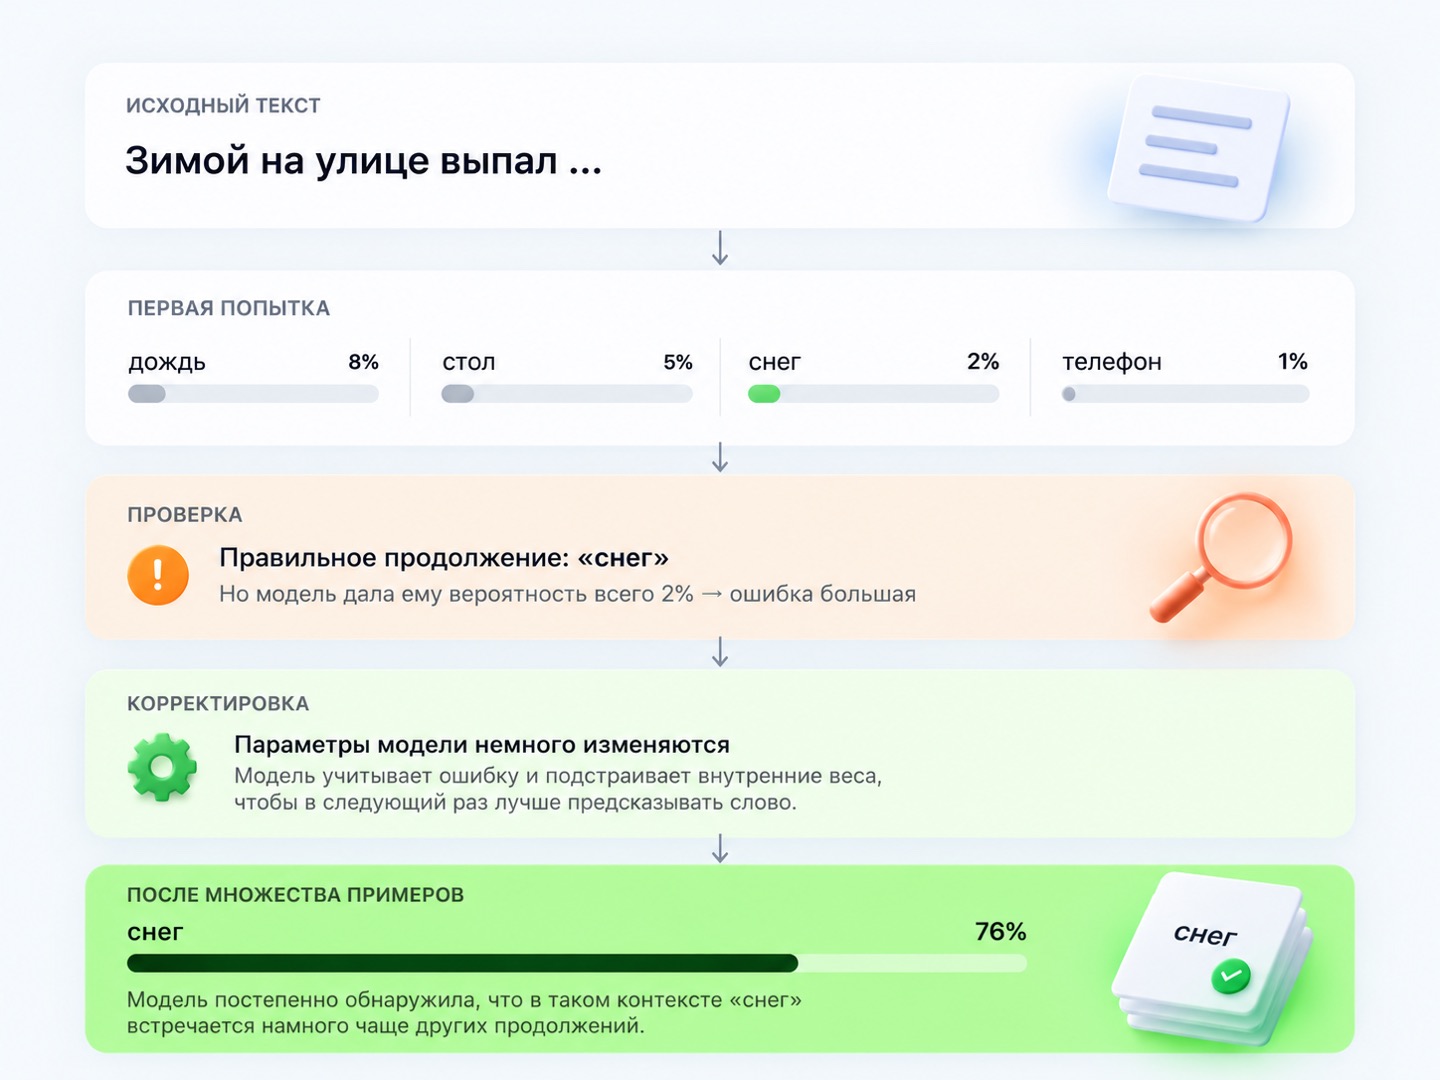
На основе этой ошибки модель подстраивает свои внутренние параметры, чтобы в следующий раз присвоить правильному варианту большую вероятность. Этот процесс повторяется миллиарды раз на разных текстах.
Со временем нейросеть усваивает статистические закономерности языка: какие слова обычно следуют друг за другом, как строится логика предложений, какие фразы чаще других завершают мысль. Таким образом она учится генерировать текст, который выглядит как написанный человеком.
4. Нейросеть учится на своих ошибках
Современная языковая модель содержит огромное количество параметров (от нескольких миллиардов до триллионов). Один параметр практически ничего не значит, но вместе они определяют, как текстовый запрос преобразуется внутри нейросети и какое продолжение в итоге получит наибольшую вероятность.
Если GigaChat неправильно предсказал следующий токен, специальный алгоритм вычисляет, какие параметры сильнее всего повлияли на ошибку. Затем их значения слегка корректируются. Этот процесс называется обратным распространением ошибки.
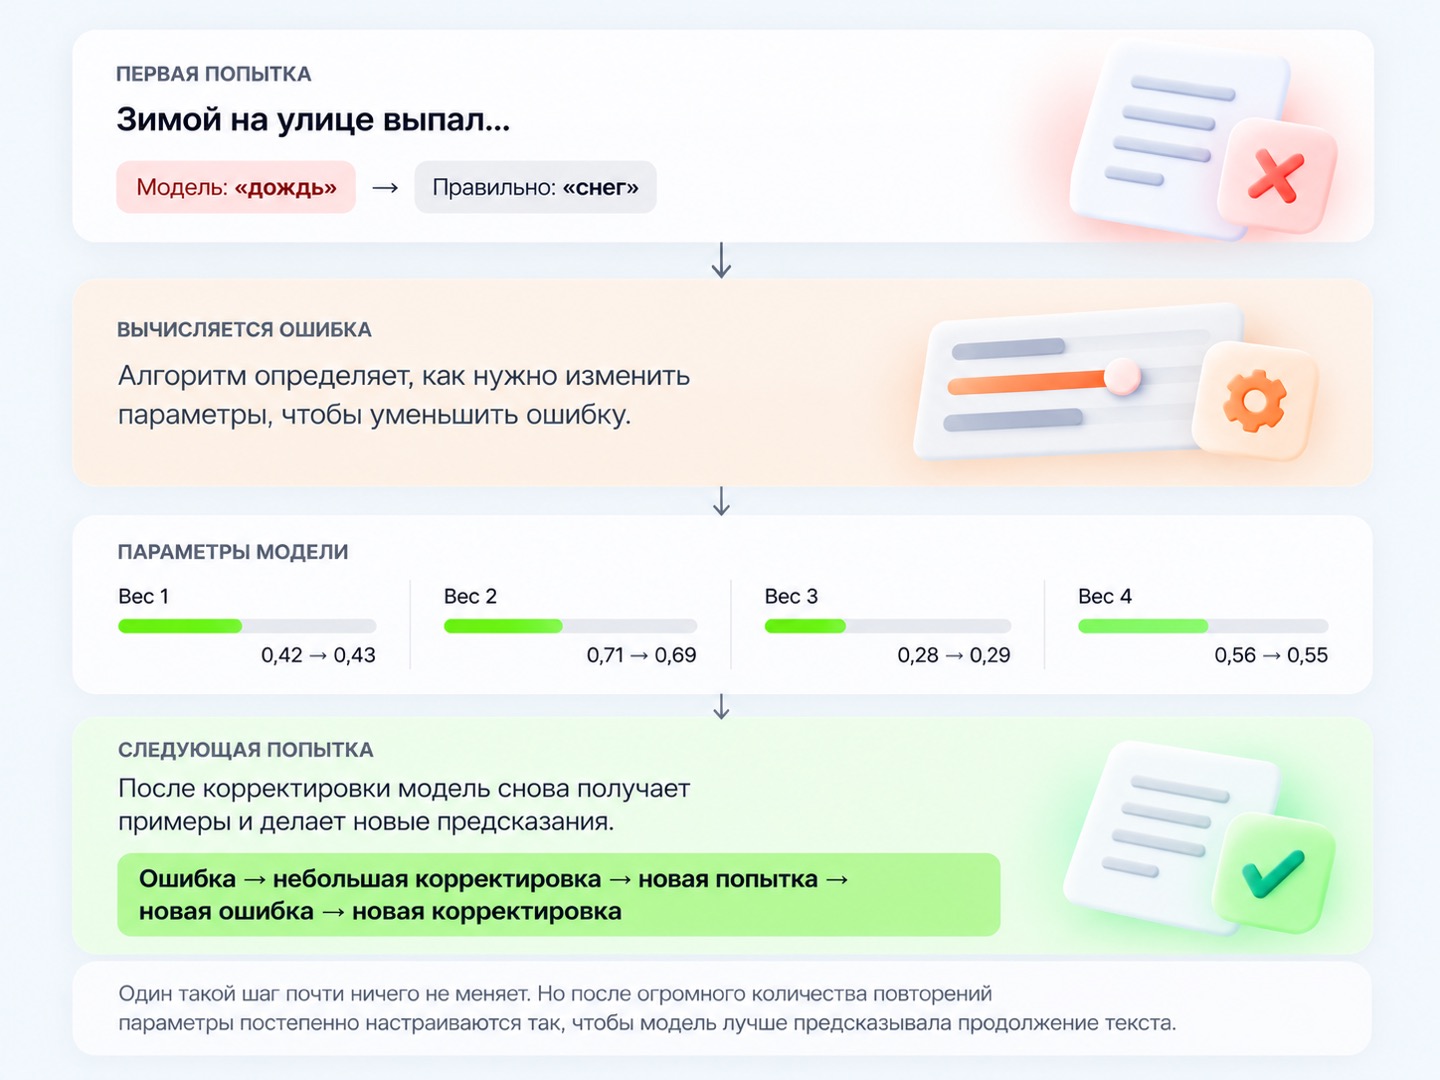
После огромного количества таких исправлений модель начинает намного лучше предсказывать текст.
Цикл повторяется на протяжении месяцев обучения, пока модель не просмотрит миллиарды текстовых примеров.
5. Откуда у нейросети появляются знания
В результате многочисленных корректировок параметров нейросеть формирует сложные связи и учится находить закономерности, которые позволяют ей отвечать на любые вопросы, а не только на те, которые использовались для обучения.
Это важное отличие нейросети от обычного поисковика: она не обязана искать страницу с точным ответом.
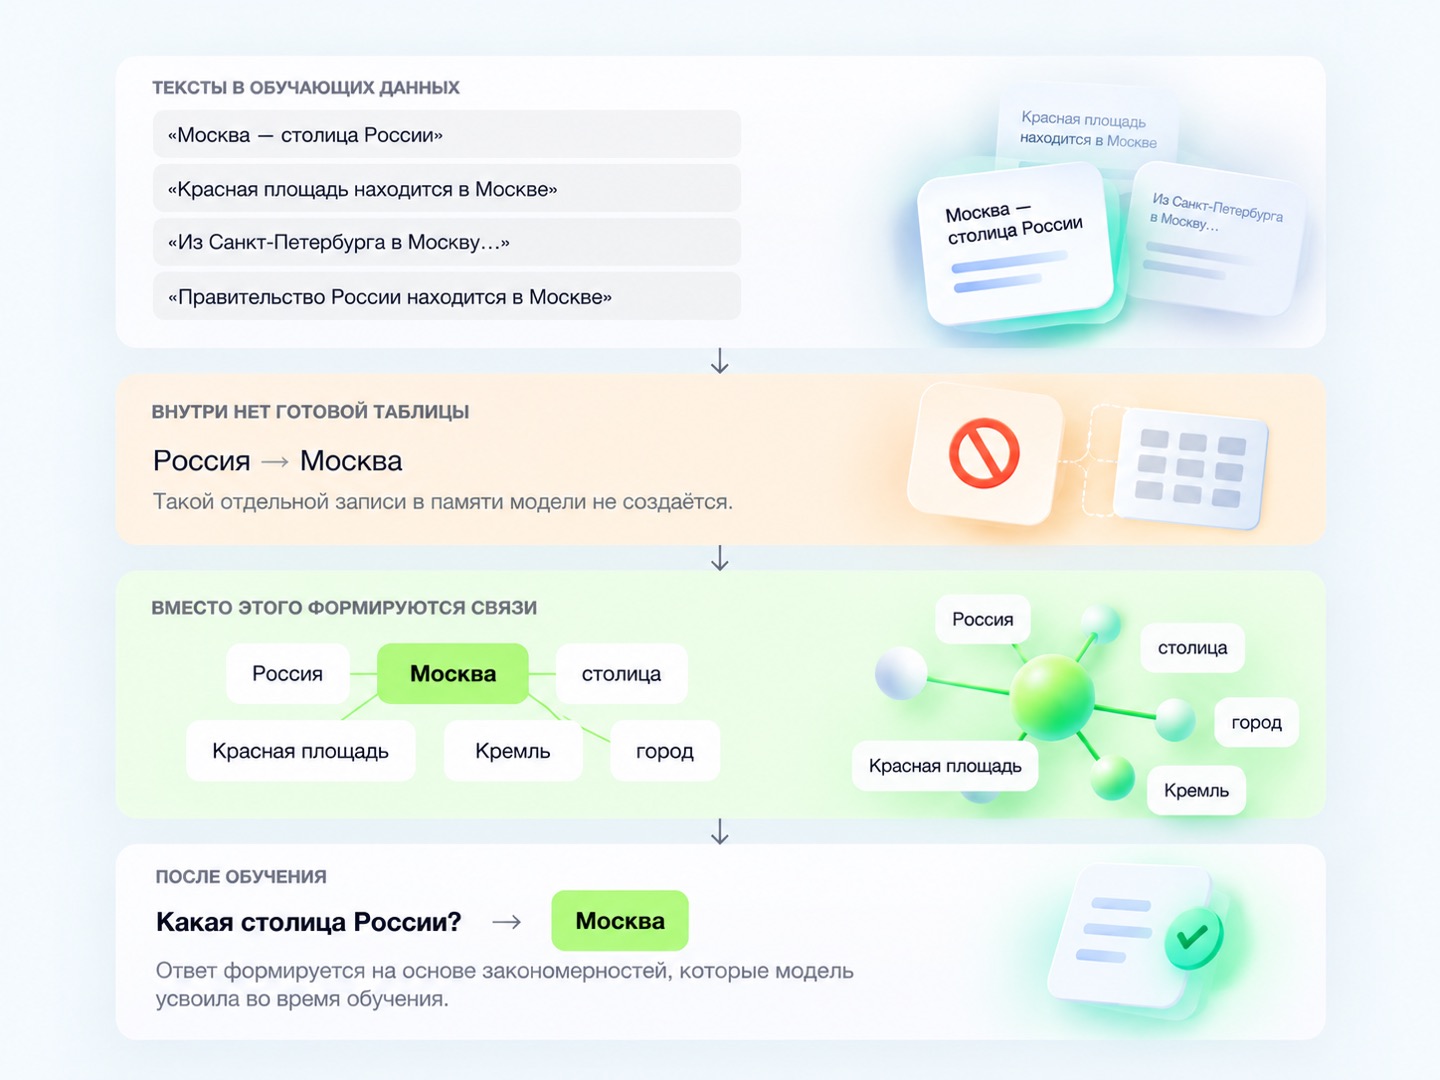
Но одновременно с этим появляется одна из главных проблем языковых моделей: иногда закономерность есть, а точного знания нет. Тогда модель начинает угадывать и не всегда делает это правильно.
Именно поэтому языковые модели иногда уверенно высказывают неправду, вплетая её в логичный, убедительный текст. Это явление называют галлюцинацией, и это одна из главных причин, по которой результаты искусственного интеллекта всегда нужно проверять.
6. Как нейросеть заставляют работать быстрее
Разберем на примере модели GigaChat 3.5 Reasoning, которая имеет 432 млрд параметров и 28 млрд активных параметров.
В большинстве случаев модели не требуются для работы все 432 млрд параметров. Во-первых, их долго обрабатывать. Во-вторых, информация, содержащаяся в них, необязательно будет полезной для нас.
Поэтому Сбер использует архитектуру Mixture of Experts (MoE). В GigaChat 3.5 Reasoning при обработке запроса используется не 432 млрд параметров, а только 28 млрд.
При использовании MoE разработчики добавляют в нейросеть «экспертов», которые специализируются на своем типе данных или темах. Когда пользователь пишет запрос, модель решает, каких именно «экспертов» стоит подключать для ответа.
7. Как нейросеть понимает контекст разговора
Все мы привыкли, что нейросети отлично понимают контекст разговора и запоминают детали.
Современные языковые модели используют механизм attention (внимание). Он позволяет каждому токену учитывать другие токены в контексте и определять, какие из них сейчас наиболее важны.
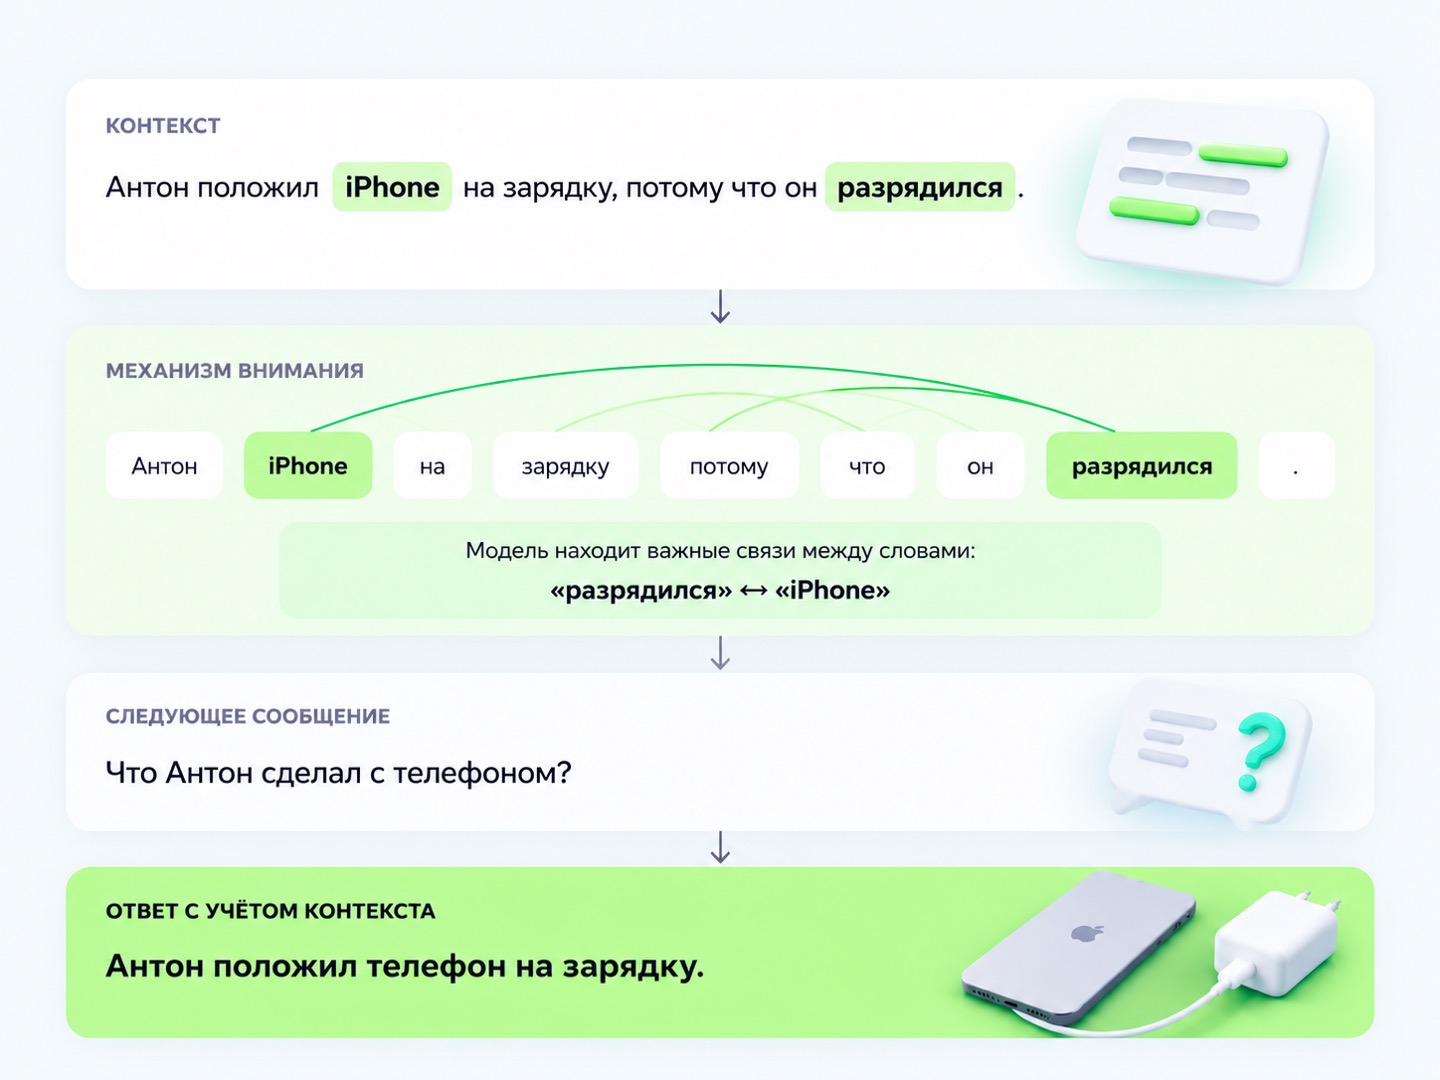
Контекст никак не связан со знаниями модели, но он учитывается в параметрах при формировании ответа.
Работает это примерно так: когда модель генерирует ответ, она анализирует все токены в вашем сообщении и вспоминает их значения. Механизм внимания вычисляет, какие части текста влияют друг на друга, и усиливает связи между релевантными элементами.
8. Как модель учат разговаривать и выполнять команды
После pre-training нейросеть уже понимает слова и вопросы и умеет генерировать ответы, но делает это очень плохо. Она может выдать большой текст там, где требуется простая пошаговая инструкция.
На этапе постобучения (SFT) модели показывают качественные примеры диалогов и ответов. Также разработчики специально загружают хорошие и плохие ответы. Задача постобучения — повысить вероятность появления хорошего варианта относительно плохого.
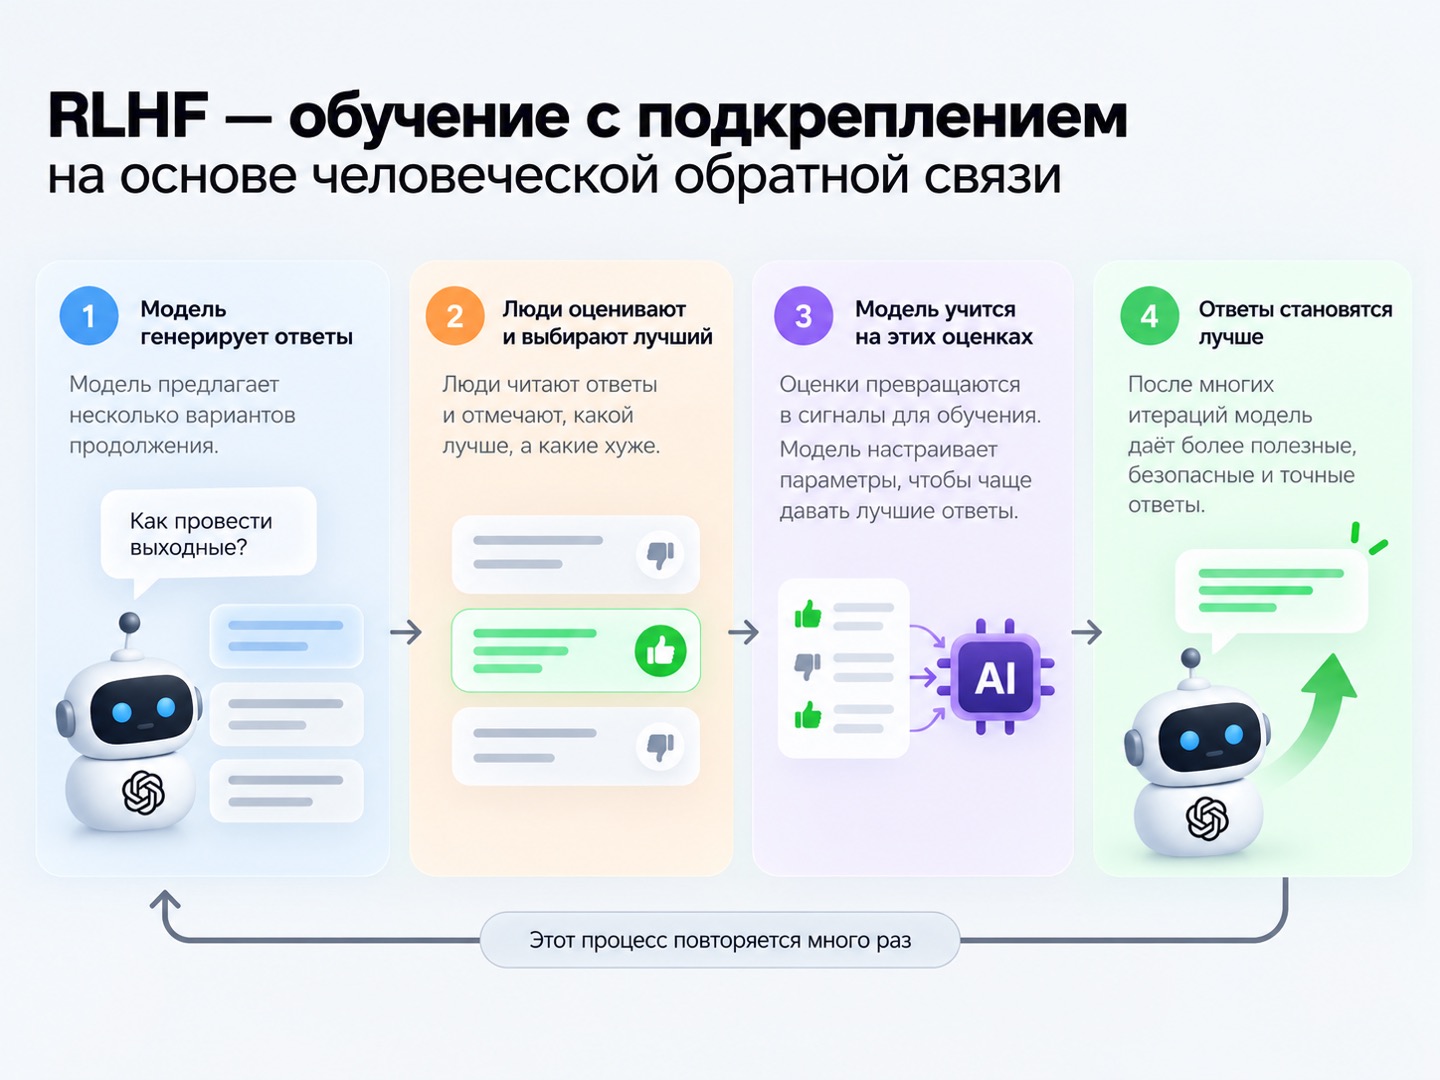
Часто в постобучении применяется метод RLHF (обучение с подкреплением на основе человеческой обратной связи). То есть уже живой человек оценивает ответы нейросети и выбирает лучший из них по заранее сформированным параметрам и собственному ощущению.
Для этого компании нанимают на работу профессионалов (юристов, врачей и т. п.) из разных сфер, чтобы они могли определить правильность ответов.
9. Как нейросеть составляет ответ на ваш вопрос
Когда мы пишем какой-либо текст, нейросеть автоматически разбивает его на токены. Они проходят через слои нейросети вместе с доступным контекстом, после чего ИИ рассчитывает вероятность ответа и начинает его писать.
Причем во время ответа нейросеть формирует вероятности продолжения на основе каждого слова, поэтому генерация происходит постепенно. Скорость генерации зависит от мощности серверов и оптимизации модели. Если модель запущена локально, то скорость ответа зависит от мощности устройства.
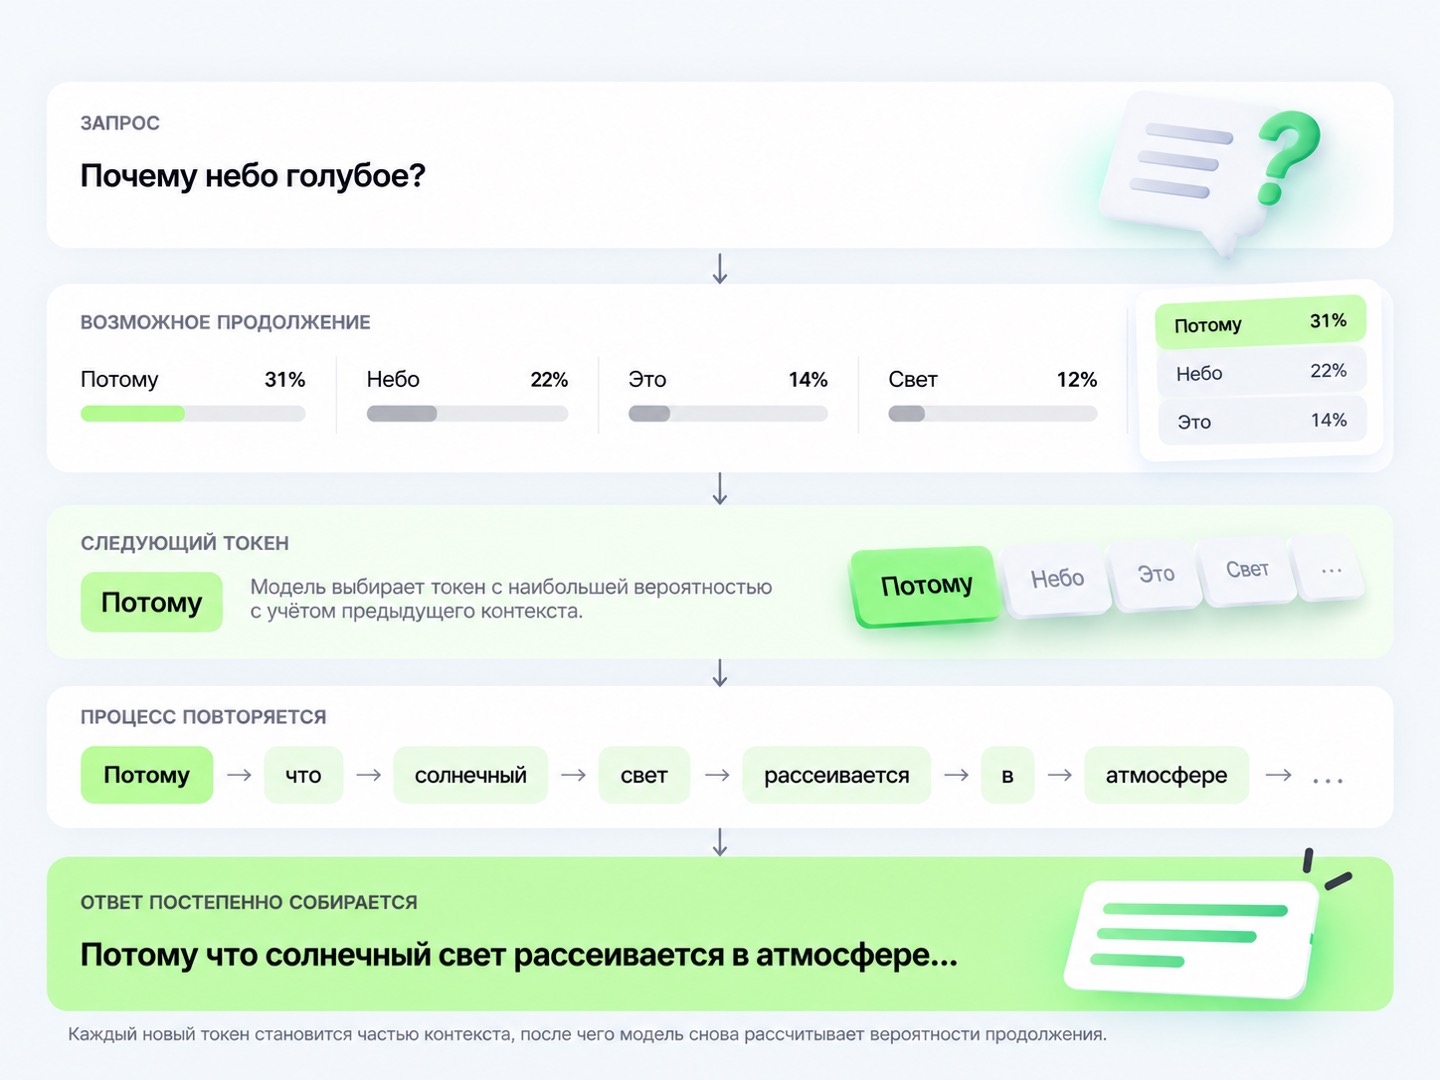
На каждом шаге модель выбирает из множества вероятных вариантов следующего токена. Это не означает, что она всегда выбирает самый вероятный. Иногда модель выбирает менее вероятный вариант, что делает ответы разнообразнее. Поэтому один и тот же вопрос может привести к разным ответам.
Именно по этому принципу работают все языковые модели.. Различаются они в основном размером параметров, количеством обучающих данных и тем, как именно они были дообучены на примерах с отзывами людей.
10. Почему ИИ иногда выдумывает факты
Задача модели — построить наиболее подходящее продолжение текста, отсюда и появляются галлюцинации и неточности.
Допустим, мы спрашиваем: «Когда родился инженер АвтоВАЗа Иван Петров?». Нейросеть прекрасно знает структуру подобных ответов: «Иван Петров родился в 19XX году в…».
Но модель не знает этого человека, потому что информации о нем не было в обучающих данных, следовательно, она не сможет назвать его дату рождения. В таком случае модель будет показывать наиболее вероятный вариант ответа, который вряд ли окажется правильным.
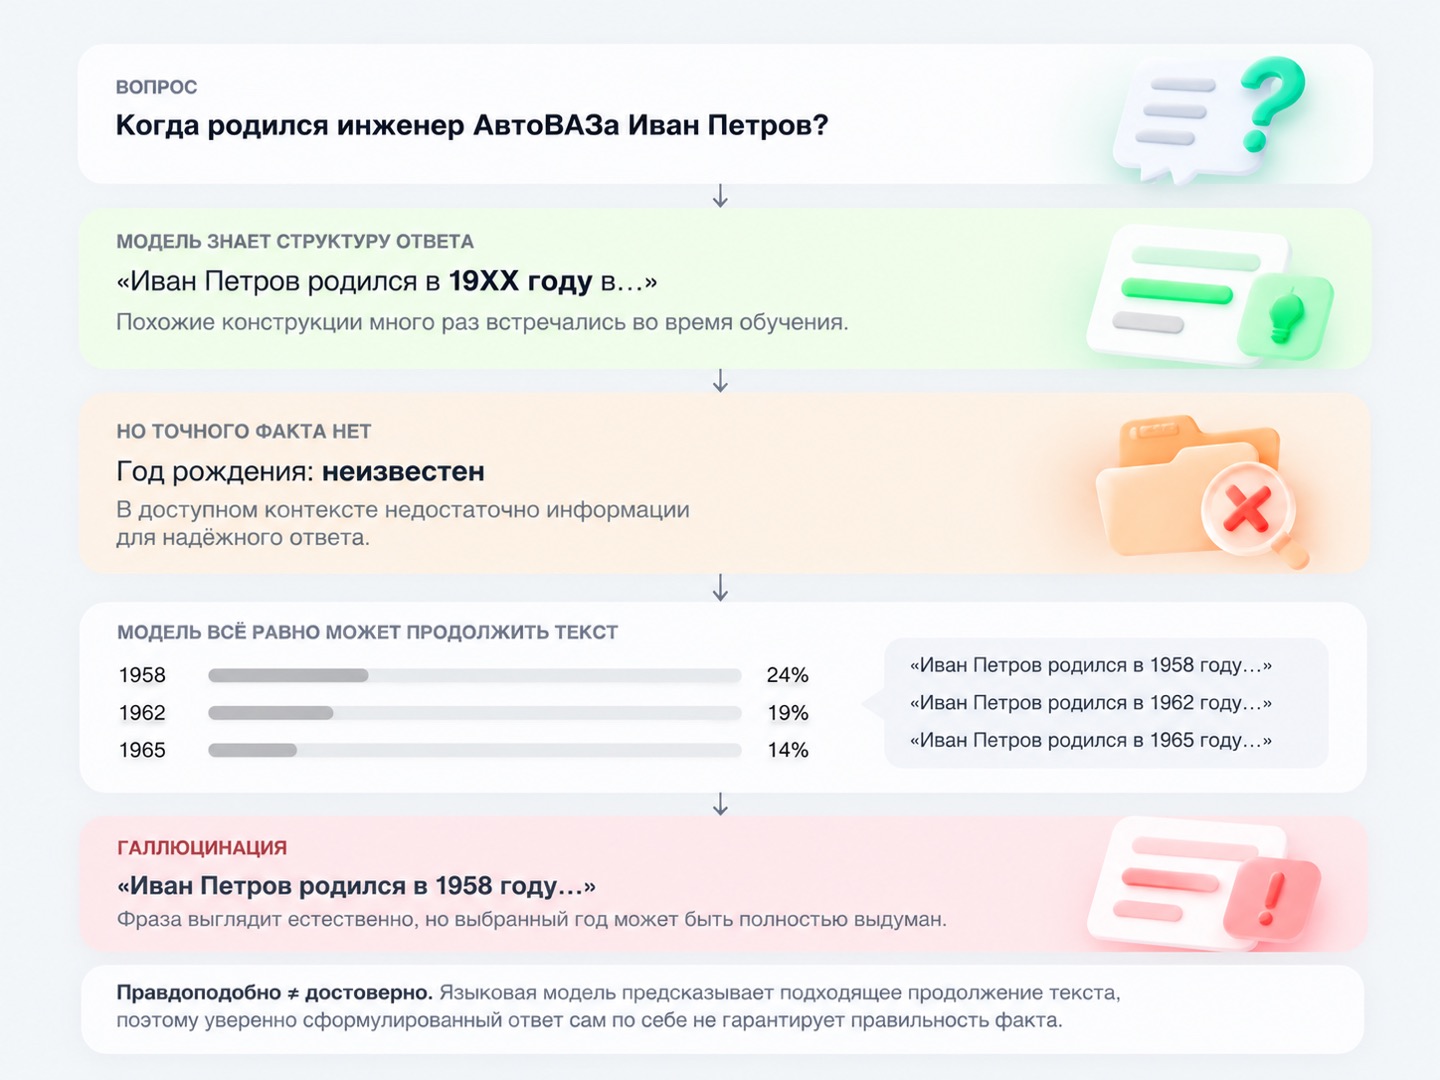
Поэтому при работе с ИИ требуется перепроверять важные данные и предоставлять больше информации для ответа на специфические вопросы.
Уменьшить количество неправильных ответов позволяет поиск в интернете. Это очень полезно для вопросов, ответы на которые постоянно меняются, например погода или курсы валют.
Но также поиск в интернете помогает нейросети получать информацию для ответа, которая не была в неё предварительно загружена.
Что в итоге
Современная нейросеть — это не огромная энциклопедия, в которой заранее записаны ответы на все вопросы. В основе её работы лежит предсказание следующего токена, но за этим простым принципом скрываются триллионы примеров, миллиарды параметров и огромное количество вычислений.
Именно поэтому качество ИИ зависит не только от размера модели. Важны данные для обучения, архитектура, постобучение и то, насколько хорошо разработчики научили модель понимать команды и работать с контекстом.
Сюда так и просится мощный комментарий