
Fun fact: если вбить свое имя в ChatGPT, Claude или Gemini, результат может удивить.
Что выйдет у вас? Пересказ старого резюме, выдуманные факты вашей биографии… И ладно это. Но ещё больше напрягает то, что рабочие черновики, медицинские вопросы и личные переписки с ботами могут использоваться для улучшения моделей.
Полностью стереть себя из нейросети намного сложнее, чем удалить профиль в соцсети. Но можно:
- ограничить использование новых диалогов для обучения
- удалить сохраненную историю и память
- при разглашении личных данных подать запрос разработчику
Разберемся, как устроен ИИ-детокс и куда нажимать, чтобы его хотя бы частично начать.
Почему у ИИ нет одной кнопки «Удалить меня»
Когда вы удаляете данные из обычного онлайн-сервиса, то там просто стираются записи в его хранилище данных.
У ИИ-сервисов к ним добавляются обученная модель, персонализация и поиск в интернете. То есть всё резко намного сложнее становится. Разделим всё это на четыре слоя…
1. Веса модели: условная «долгосрочная память». Во время обучения нейросеть усваивает закономерности из текстов и других материалов. Результат отражается в ее математических параметрах. Это не картотека, в которой можно найти отдельную строку с вашей фамилией и стереть ее.
Удаление исходного документа из хранилища не меняет уже обученную модель. Для работы с ее параметрами исследуют методы Machine Unlearning, или машинного разучивания. А ограничить выдачу конкретных персональных данных можно отдельно через обращение к разработчику.
2. Защитные механизмы на выходе. Этот слой отвечает за то, какую информацию бот выдает пользователю. Разработчики настраивают защитные механизмы, чтобы блокировать разглашение персональных данных. В таком случае ограничение работает на уровне ответов.
3. Поиск в реальном времени. Бот может получить сведения о вас из интернета непосредственно перед ответом. Если он ссылается на старую страницу с адресом или резюме, имеет смысл добиваться удаления или исправления первоисточника и обновления поисковой выдачи.
4. История чатов и функция «Память». Здесь находятся сохраненные диалоги, файлы и сведения для персонализации. Их обычно можно просматривать и удалять через интерфейс. История, память и разрешение на обучение управляются отдельно. Ниже разберемся с каждым пунктом.
Почти все эти слои можно хотя бы частично почистить от ваших данных, но это будет непросто. Поехали…
Уровень 1. Запрещаем ИИ учиться на ваших чатах и чистим «Память»
Вначале отключаем использование новых диалогов для обучения и удалить сохраненные сведения о себе.
Далее показываю, куда нажимать в личных аккаунтах популярных сервисов.
OpenAI (ChatGPT)
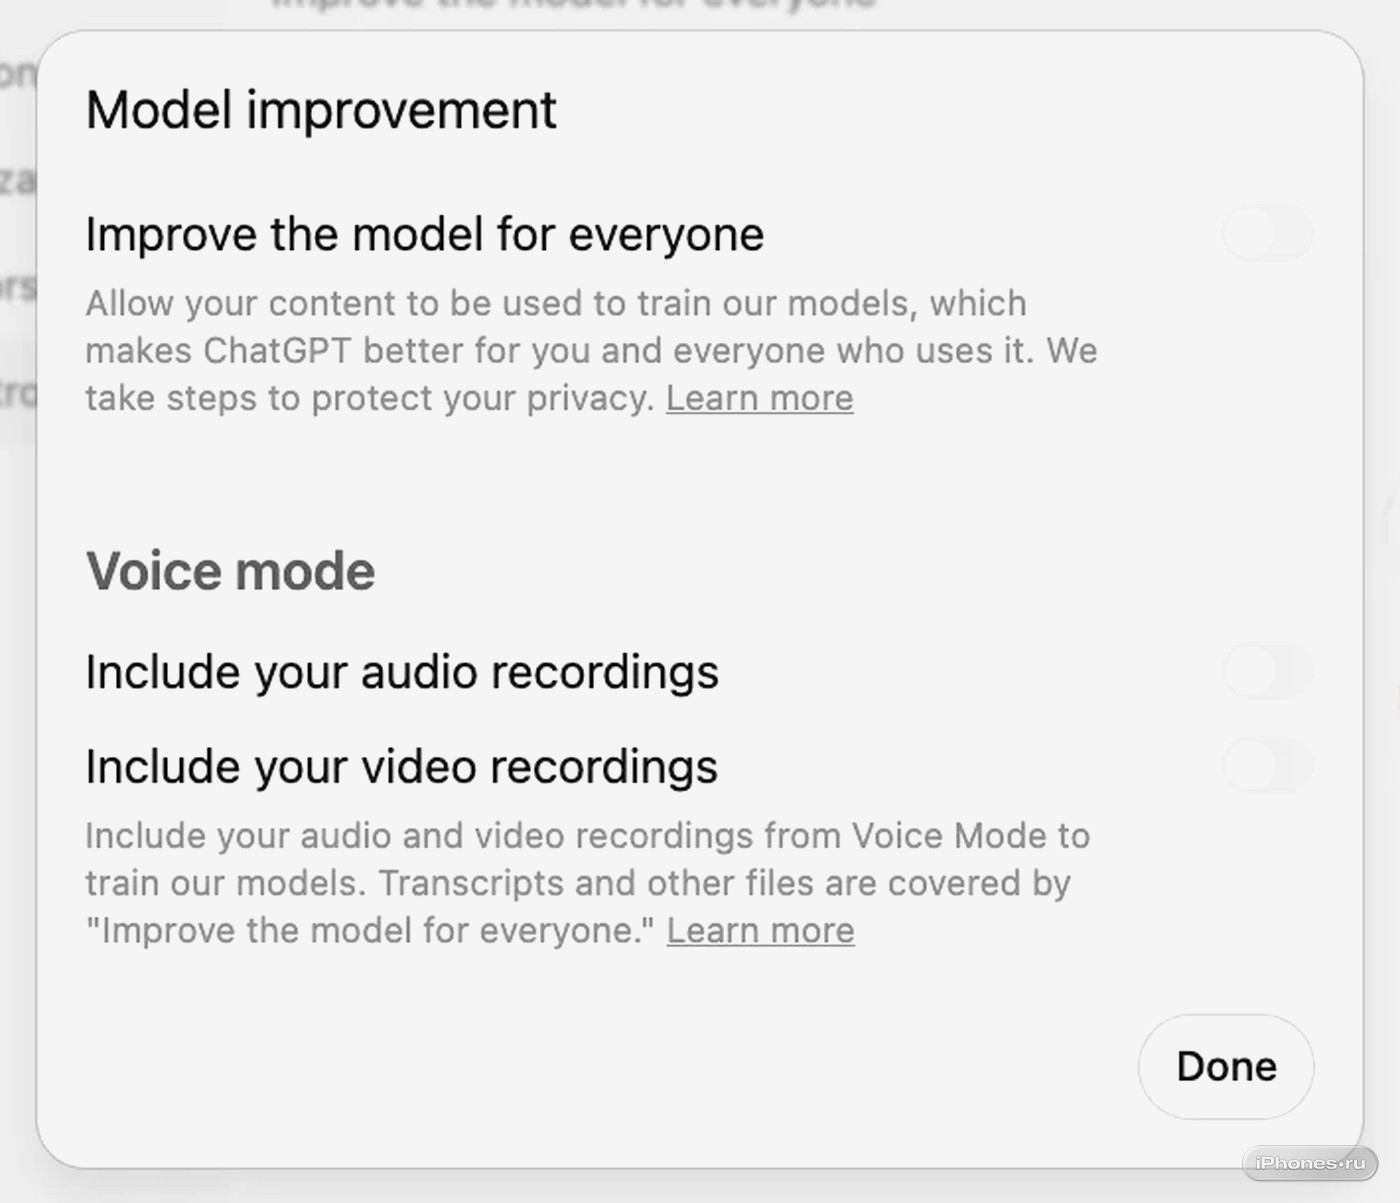
▸ Запрет на обучение: откройте настройки ChatGPT, перейдите в Data controls (Управление данными), откройте Improve the model for everyone (Улучшать модель для всех) и отключите переключатель.
История чатов при этом сохраняется. Для передачи аудио- и видеозаписей на обучение предусмотрены отдельные настройки там же.
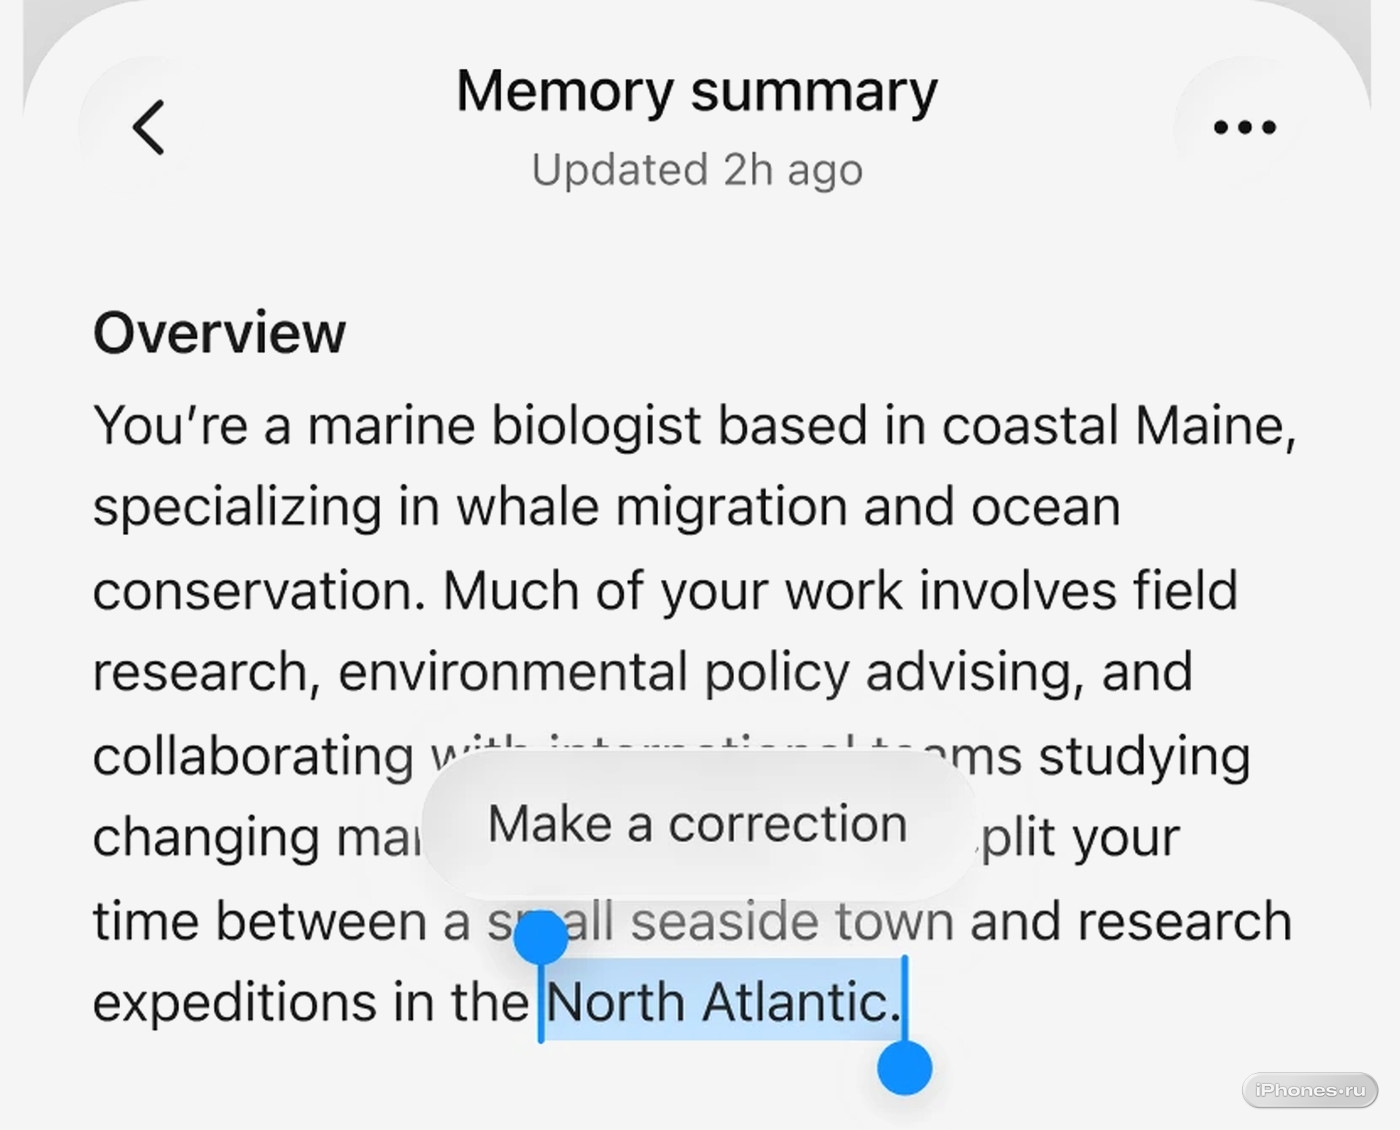
▸ Очистка памяти: зайдите в Settings → Personalization → Memory. Откройте сводку памяти или список сохраненных фактов через Manage. Здесь можно просмотреть, исправить и удалить сведения о себе.
Для полной очистки удалите и сохраненные факты, и переписки с соответствующей информацией. Проверьте также загруженные файлы и подключенные приложения. ChatGPT использует их для персонализации ответов.
Google (Gemini)
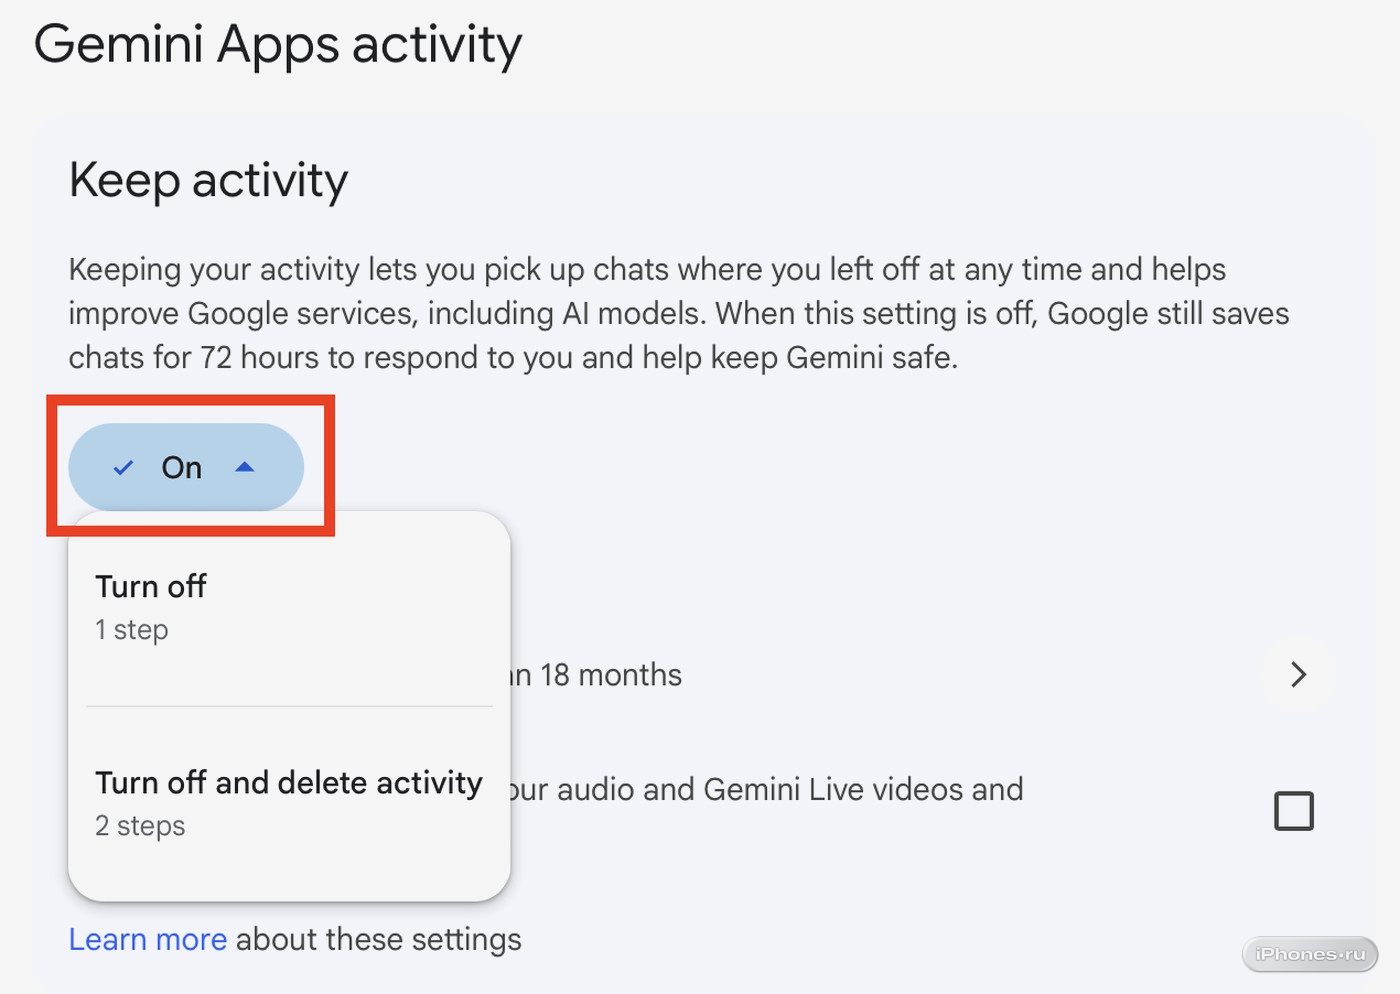
▸ Отключение истории и использования новых чатов для обучения: перейдите в историю приложений Gemini. Найдите Keep Activity, нажмите кнопку включенного состояния и выберите «Отключить» либо «Отключить и удалить историю» (Turn off and delete activity). Во втором случае потребуется подтвердить удаление прошлой активности.
Важно: при включенной истории часть чатов проверяют специалисты Google. Проверенные отрывки хранятся отдельно от аккаунта до трех лет. Управление историей описано в центре конфиденциальности Gemini.
Anthropic (Claude)
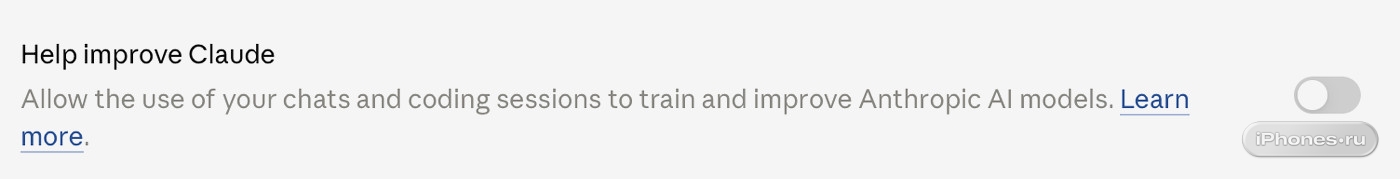
В Claude за использование переписок и сессий программирования для обучения отвечает отдельный переключатель в настройках приватности.
▸ Проверка настроек: откройте раздел Privacy в Claude и отключите Help improve our AI models / Help improve Claude.
После отключения сохраненные и новые диалоги исключаются из будущих запусков обучения. Порядок действий приведен в инструкции Anthropic.
Meta* AI (Instagram*, Facebook*, WhatsApp)
*Meta Platforms Inc., владеющая Facebook* и Instagram*, признана экстремистской организацией, её деятельность запрещена в России.
Meta* использует для обучения в том числе публичные публикации взрослых пользователей и взаимодействия с Meta* AI. Обычные личные сообщения друзьям и семье компания не использует, если кто-то из участников не передает их ИИ.
▸ Как подать возражение: проверьте уведомление об использовании данных для ИИ и Центр конфиденциальности в своем аккаунте. Для пользователей ЕС Meta* предусматривает форму возражения.
Дополнительно переведите профиль в закрытый режим, чтобы ограничить доступ к новым публикациям.
Perplexity AI
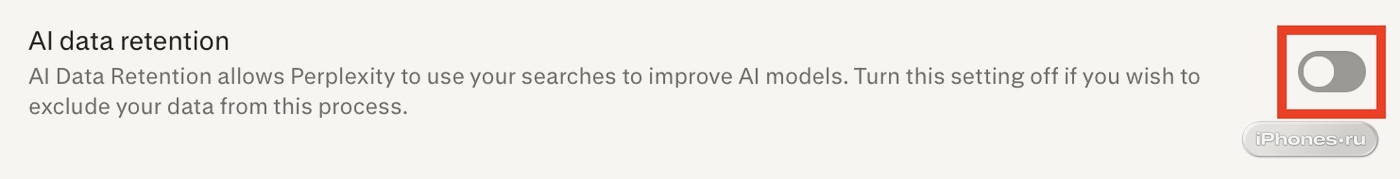
▸ Откройте настройки аккаунта Perplexity, перейдите в Preferences и выключите AI data retention.
Для личных тарифов Free, Pro и Max настройка включена по умолчанию. Отключение исключает новые данные из обучения.
Яндекс (Алиса) и Сбер (ГигаЧат)
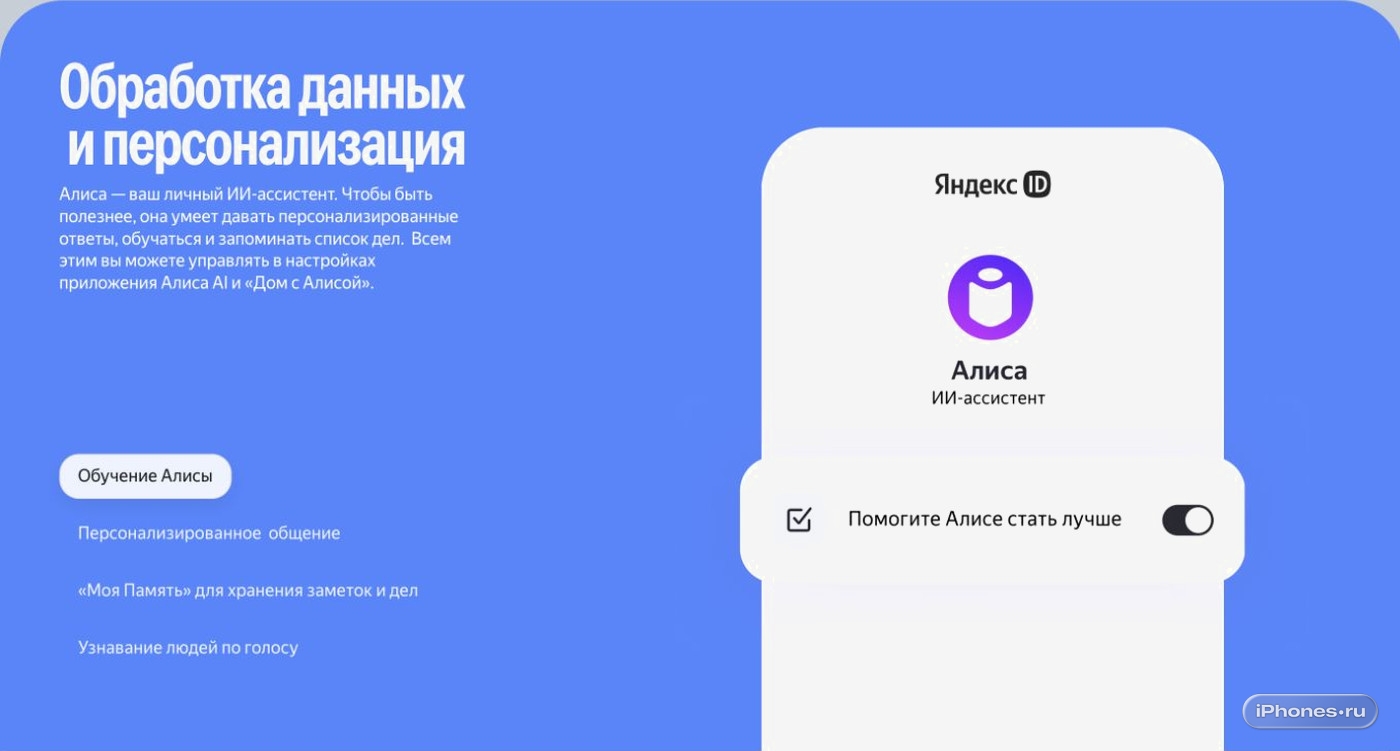
▸ В экосистеме Яндекса: откройте Данные → Доступы к данным в Яндекс ID, выберите Алису и отключите участие в улучшении ассистента. Яндекс указывает, что после отказа новые диалоги исключаются из обучения. Уже накопленные данные можно отдельно удалить через раздел управления данными Яндекс ID.
▸ В ГигаЧате: найдите диалог в списке слева, нажмите три точки и выберите «Удалить». Именно этот путь описан в инструкции сервиса.
Уровень 2. Как запросить удаление информации о себе из ответов нейросети
Если чат-бот выдает ваш домашний адрес, телефон или ложные сведения постороннему пользователю, настроек собственного аккаунта недостаточно. Здесь нужен запрос разработчику на удаление, исправление или ограничение выдачи конкретных персональных данных.
Шаг 1. Зафиксируйте доказательства. Сделайте скриншоты диалога и сохраните точные формулировки запросов, которые привели к проблемному ответу. Добавьте дату, название сервиса и ссылки на источники, если бот их указал.
Шаг 2. Проверьте первоисточник. Если бот берет сведения с сайта, попросите его владельца удалить или исправить информацию. После изменения страницы можно воспользоваться инструментом обновления устаревшего контента Google или удаления страниц из поиска Яндекса.
Если адрес или телефон по-прежнему опубликован, у Google есть отдельная процедура удаления личной информации из поиска.
Шаг 3. Отправьте запрос разработчику.
▸ В OpenAI: перейдите на портал приватности, нажмите Make a Privacy Request и выберите Remove personal data from ChatGPT responses. Укажите проблемные ответы, точные данные и причину обращения. По инструкции OpenAI, потребуется подтверждение личности. Подать запрос можно и без аккаунта ChatGPT.
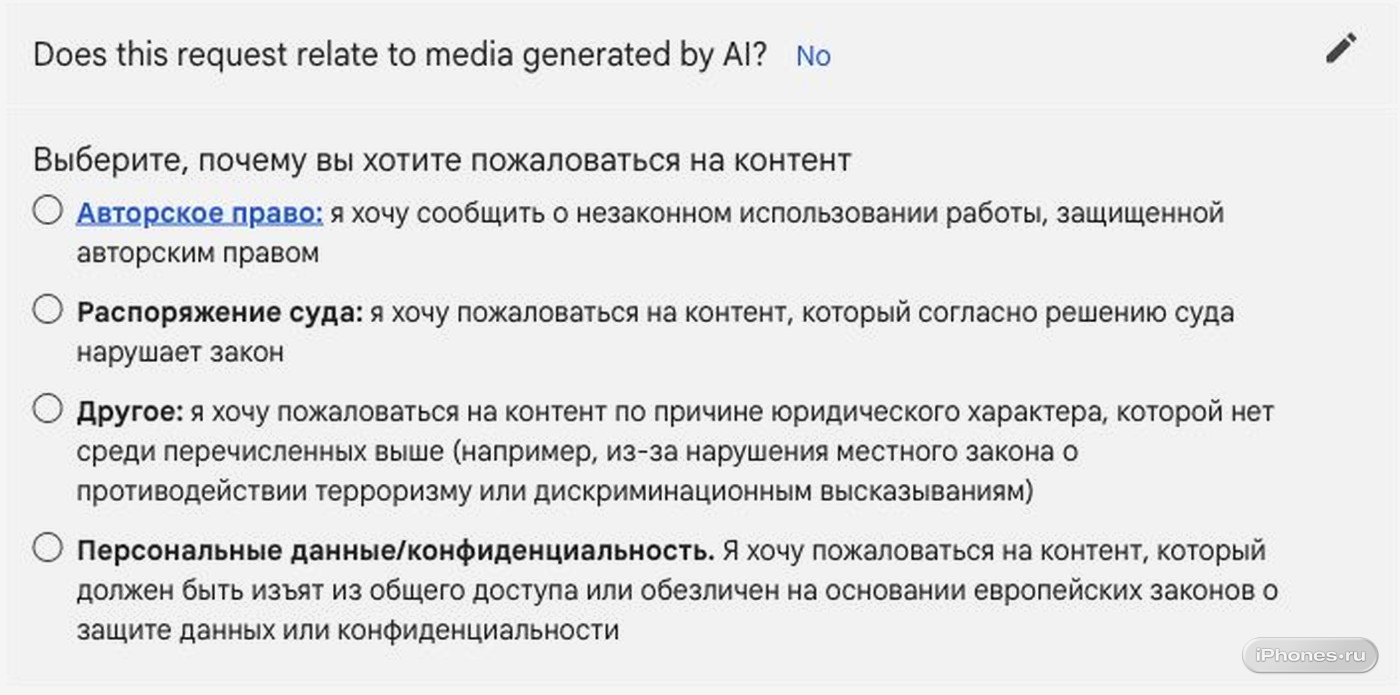
▸ В Google: для проблемного ответа Gemini используйте форму жалобы на контент, выбрав «Дополнительные продукты» → Gemini. Для текстового ответа отметьте No в вопросе о сгенерированных медиа. Затем выберите причину обращения и заполните форму. Также можно открыть меню под ответом Gemini и выбрать сообщение о юридической проблеме.
▸ В Anthropic: обратитесь через Privacy Center или на privacy@anthropic.com. Укажите конкретные персональные данные, приложите скриншоты, запросы и ссылки. Компания просит именно эти сведения для рассмотрения обращения.
В обращении полезно отдельно обозначить, чего вы хотите: удалить сохраненные данные, прекратить их использование для будущего обучения или ограничить появление конкретной информации в ответах.
Срок ответа на запрос по статье 12 GDPR составляет один месяц.
Бонус: как ограничить сбор данных с собственного сайта
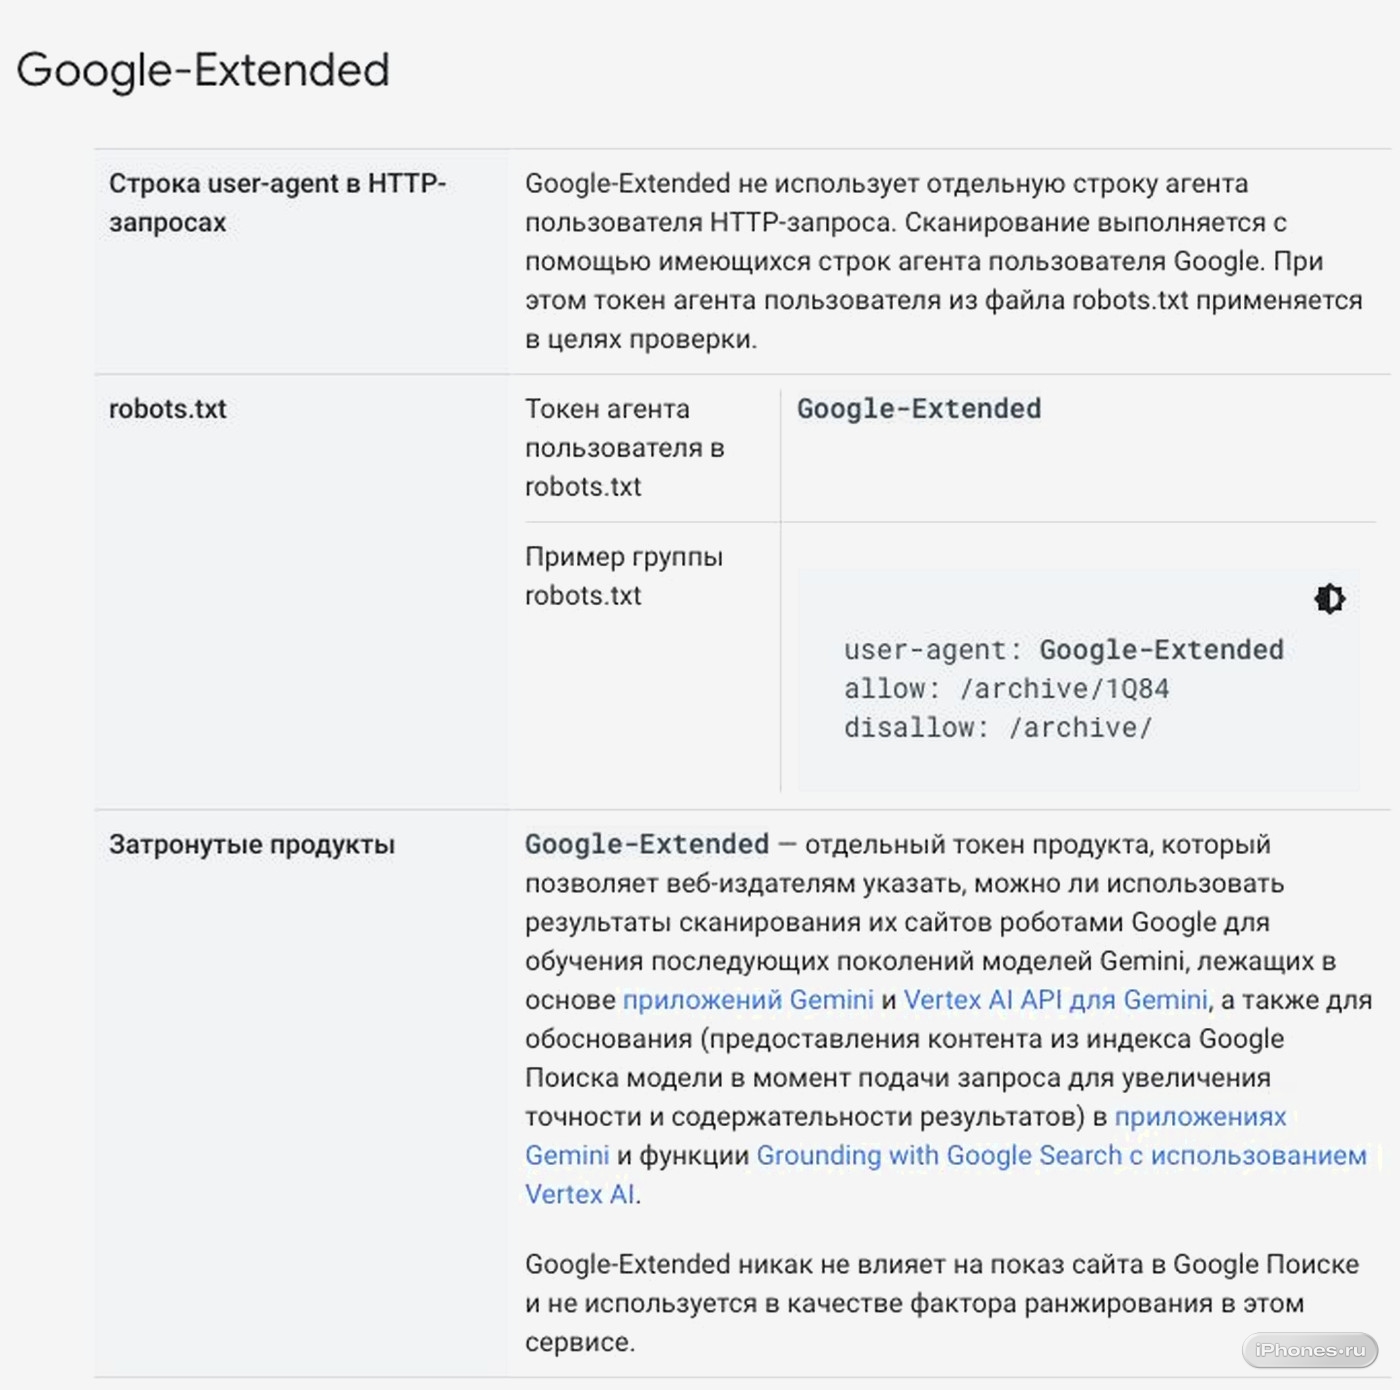
Если у вас есть собственный сайт, портфолио или блог, можно ограничить сбор материалов некоторыми краулерами. Для этого добавьте в корневой файл robots.txt правила для соответствующих ботов:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /
Обычные поисковые роботы Googlebot и Яндекса продолжат работать. Google-Extended управляет использованием контента для обучения Gemini и его предоставлением модели из поискового индекса в продуктах Gemini и Vertex AI. На обычное ранжирование Google Поиска этот токен, по документации Google, не влияет.
У OpenAI запрет GPTBot также отделен от поискового OAI-SearchBot. Так можно запретить сбор для обучения, сохранив присутствие сайта в поиске ChatGPT.
ИИ хорош как инструмент, факт. Но его «память» не должна превращаться в слежку за личной жизнью, как бы того не хотели Сэм Альтман и прочие самопровозглашённые техноимператоры.
Пару минут на читку настроек и один запрос в форму поддержки я считаю небольшой ценой за то, чтобы секреты, адреса и черновики принадлежали только вам, а не очередной обучающей выборке.
Всем желаю вернуть контроль над собственным цифровым следом и впредь поменьше делиться с цифровым тоталитаризмом западных ИИ-гигантов.


1 комментарий